VlogMe

Голос → видео с аватаром Превратите голос ElevenLabs в видео с аватаром

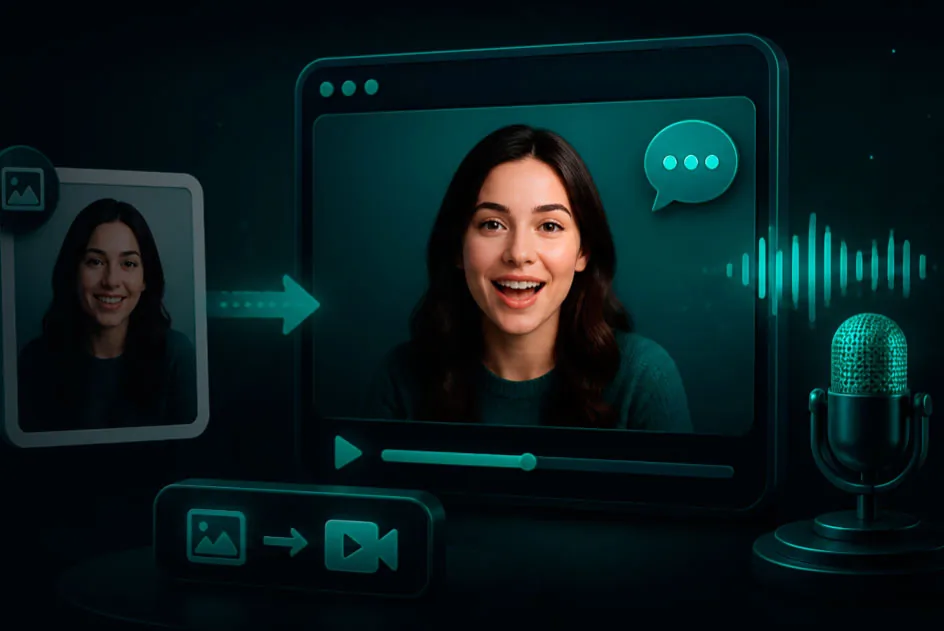
Загрузите готовую голосовую дорожку и портрет. VlogMe перенесёт реальный темп, паузы и подачу на говорящего аватара.

  • Настройка без регистрации
  • Файлы остаются локальными, пока вы не продолжите
  • Стоимость в кредитах видна до рендера

Попробуйте на своём файле

Настройте генерацию

После входа фото и аудио загрузятся в Lab и откроются в Talking avatar в Video Studio с моделью Hedra Avatar.

  1. Экспортируйте голос
  2. Добавьте портрет
  3. Задайте подачу
  4. Запустите рендер

01Голос на входе — ведущий на выходе

У голосовой дорожки появляется лицо

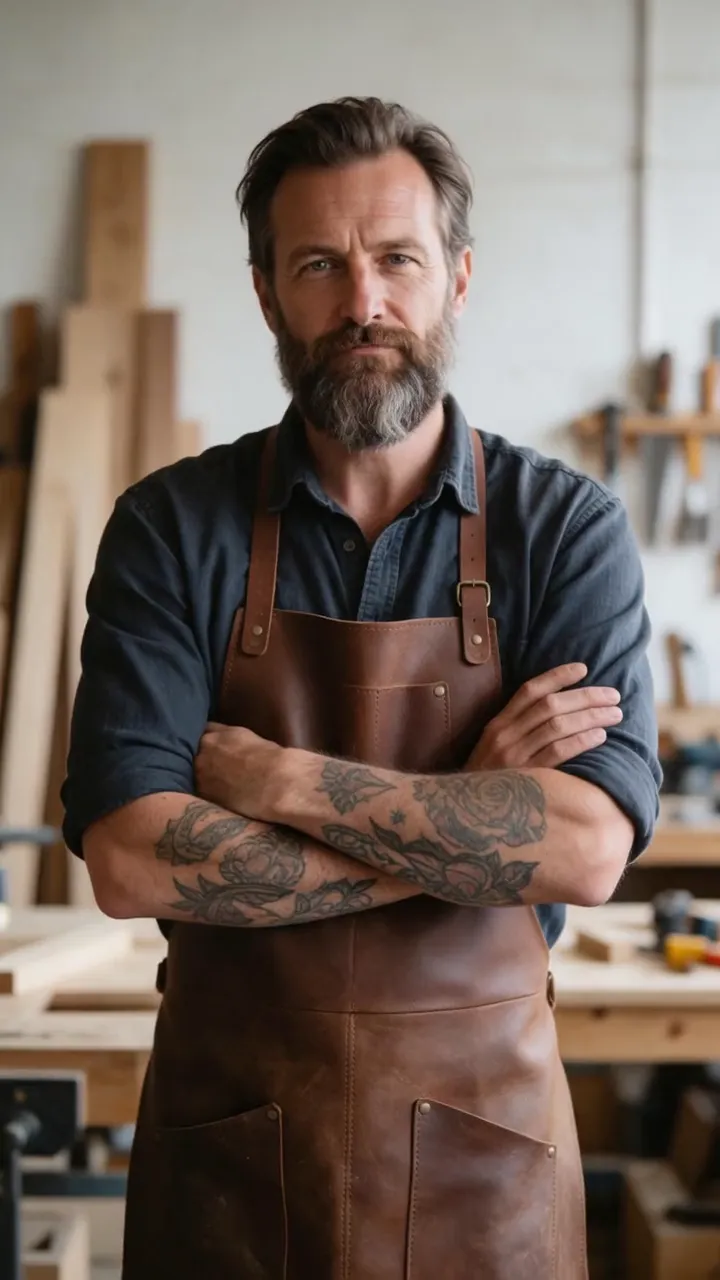
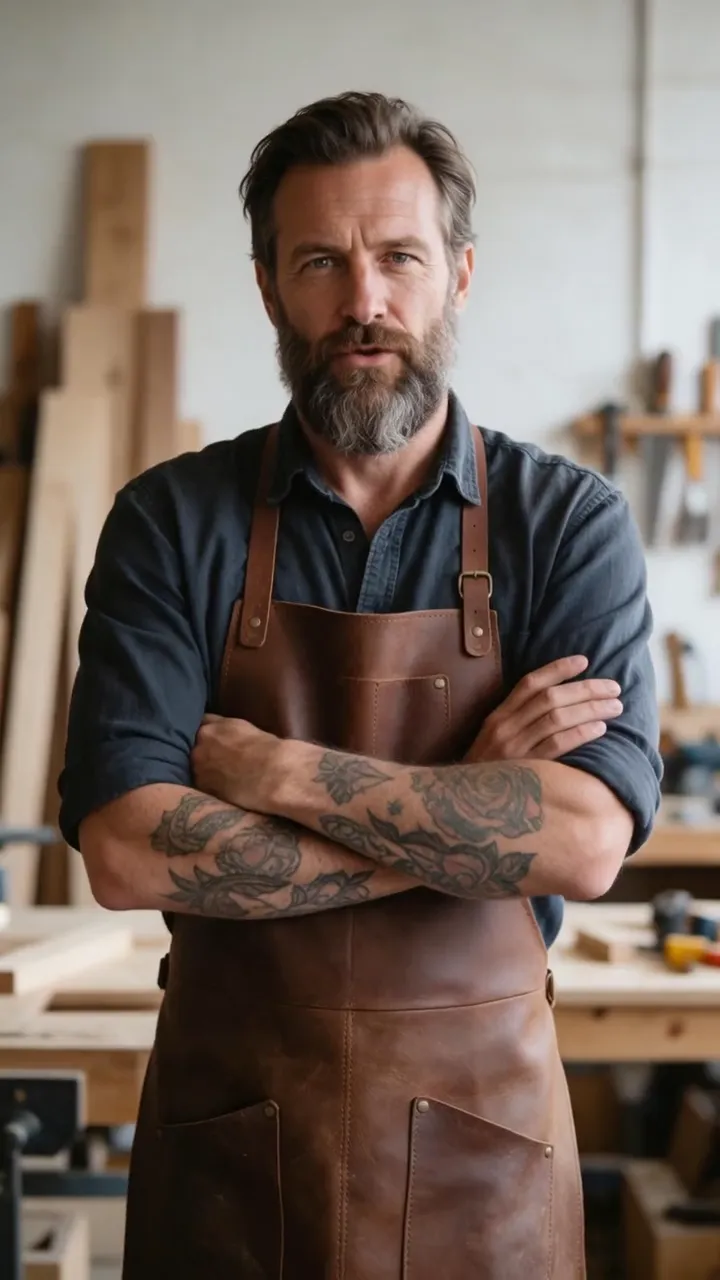
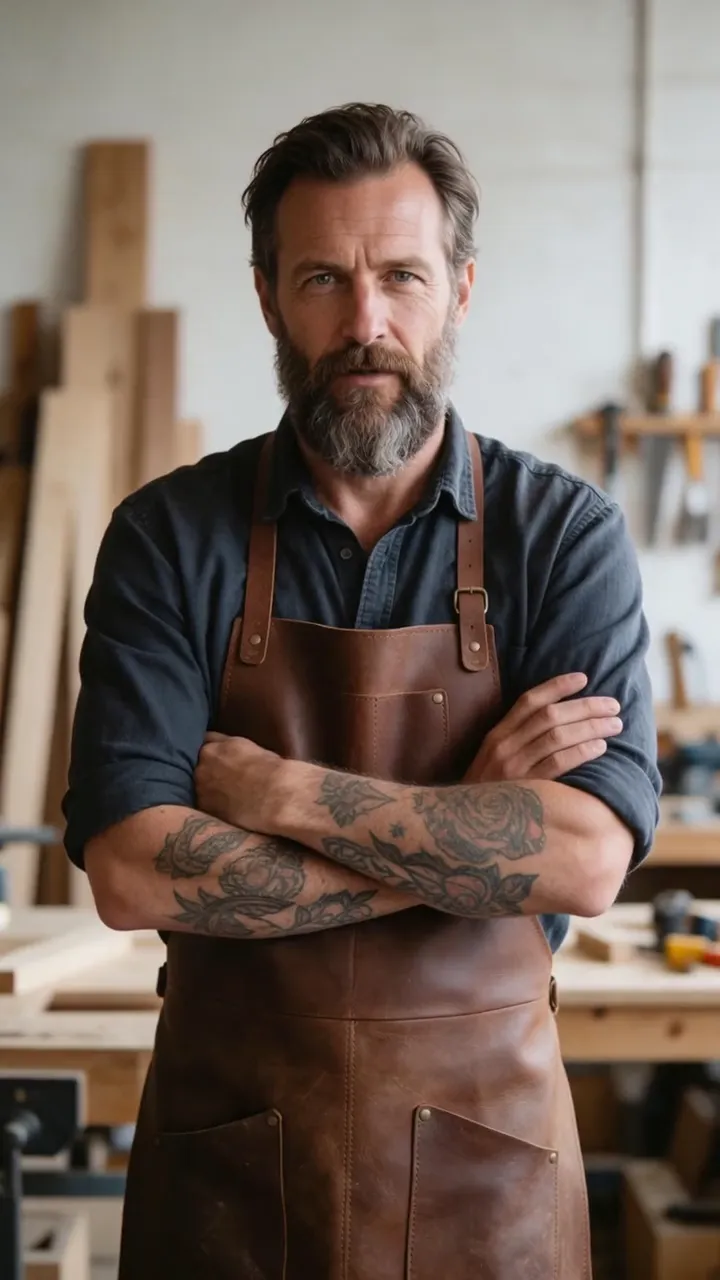
Этот столяр произносит девятисекундную дорожку, созданную в ElevenLabs v3, — точно такой же файл вы экспортируете из ElevenLabs. Hedra Avatar синхронизирует с ней губы портрета: паузы, ударения и вдохи берутся из аудио, а сам голос не генерируется заново.

  • Можно загрузить финальный аудиофайл ElevenLabs в формате MP3, WAV или M4A
  • Темп, паузы и длительность загруженной дорожки задают исполнение аватара
  • К голосу можно добавить портрет человека, персонажа или иллюстрацию с разрешением на использование
  • Выбранный голос сохраняется, а видео добавляет к нему ведущего с синхронизацией губ
Голос в аватар: бородатый столяр в кожаном фартуке рассказывает, как ухаживает за инструментами
Hedra Avatar · 9:169:16
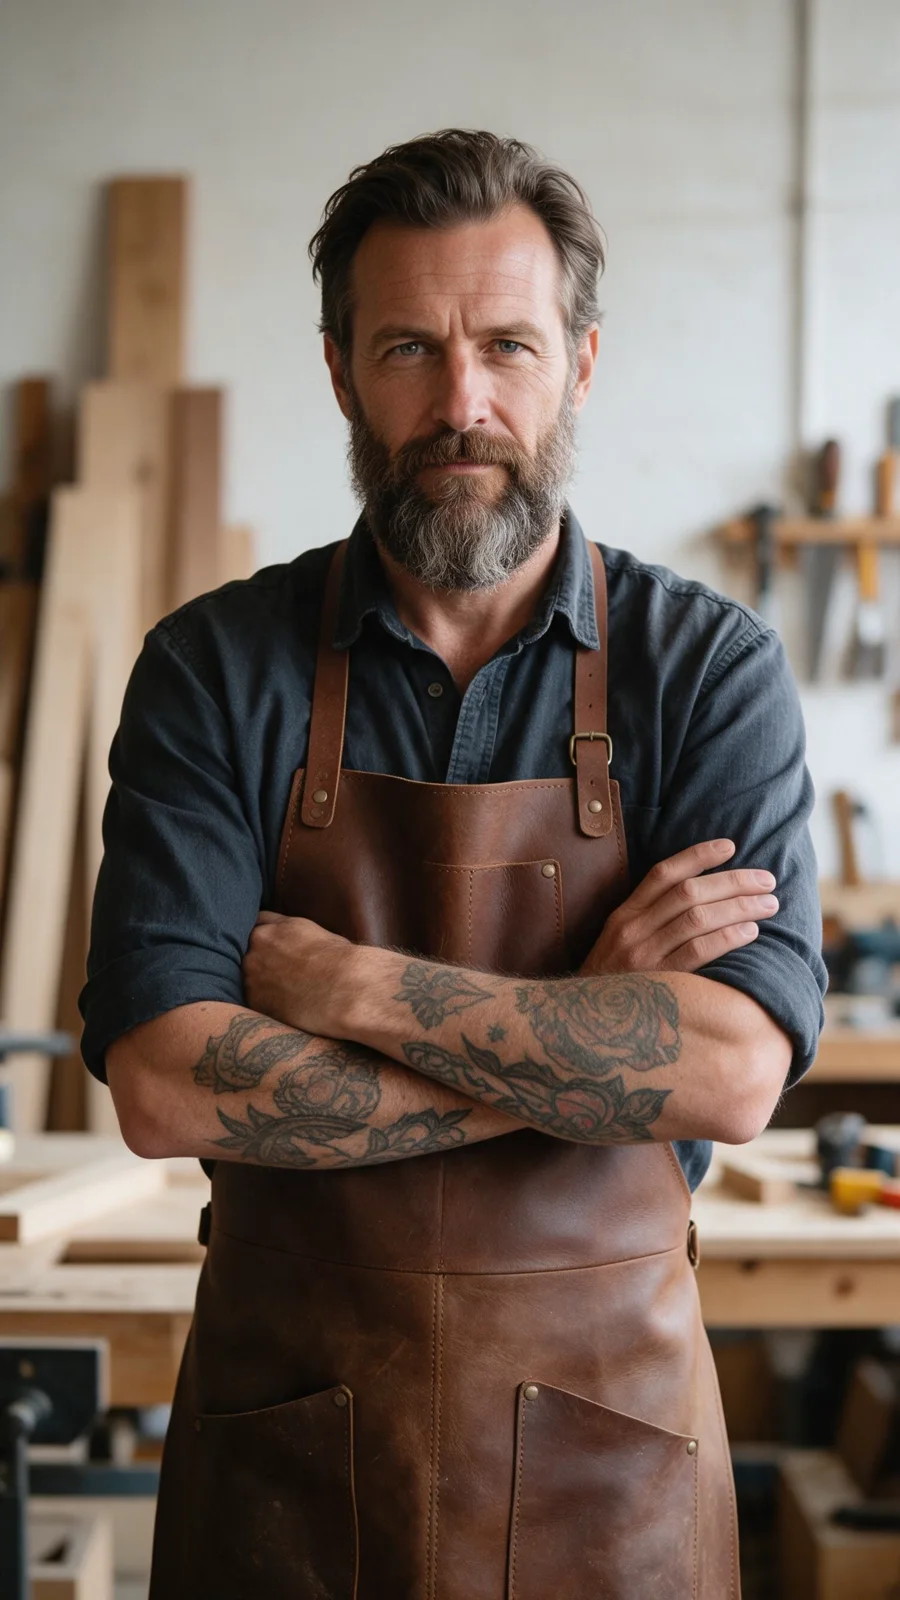
Исходный портрет: столяр в кожаном фартуке
Портрет

02Показываем и объясняем

Голос ведёт. Лицо следует за ним.

01Ваш голос

Возьмите дубль, который уже утверждён.

Экспортируйте финальный MP3, WAV или M4A из ElevenLabs или создайте голос в Audio Studio VlogMe. Подойдут файлы до 50 МБ; с Hedra Avatar видео может длиться до десяти минут и всегда совпадает по длине с аудио.
Загрузить голосовой файл

02Формат кадра

Вертикаль, квадрат или горизонталь из одного аудио.

Один голосовой файл озвучит Short в 9:16, пост для ленты в 1:1 и урок в 16:9. Выбирайте формат под каждую площадку, не трогая запись.

Загрузить голосовой файл
Тот же столяр с другим, более спокойным голосом рассказывает о мастерской на рассвете
Другой голос · 9:169:16
Исходный портрет: столяр в кожаном фартуке
Тот же портрет

03Любой голос

То же лицо, голос спокойнее.

Мы оставили портрет столяра и подставили другой голос ElevenLabs — мягче и спокойнее по тембру. Губы, паузы и ударения следуют за новой дорожкой: всё задаёт аудио.

Загрузить голосовой файл

Video StudioГенератор ИИ-аватаров

Все инструменты для говорящих аватаров
  1. Исходный материалПортрет и подготовленное аудио
  2. РезультатВидео с говорящим аватаром
Продолжить в Video Studio

Работает в связке

03Как это работает

Три шага от голосового файла до видео

  1. Экспортируйте финальный голос

    Доведите произношение, паузы и ударения в ElevenLabs до загрузки.

  2. Выберите изображение аватара

    Используйте портрет, который принадлежит вам или на анимацию которого есть лицензия.

  3. Создайте исполнение

    VlogMe переносит загруженную дорожку на аватара и собирает видео.

  • MP3 · WAV · M4A
  • Hedra Avatar
  • OmniHuman 1.5
  • До 10 мин
  • 9:16 · 1:1 · 16:9

Готовые примеры

Приветствие новичку, секрет пасты по-итальянски и приглашение в мастерскую

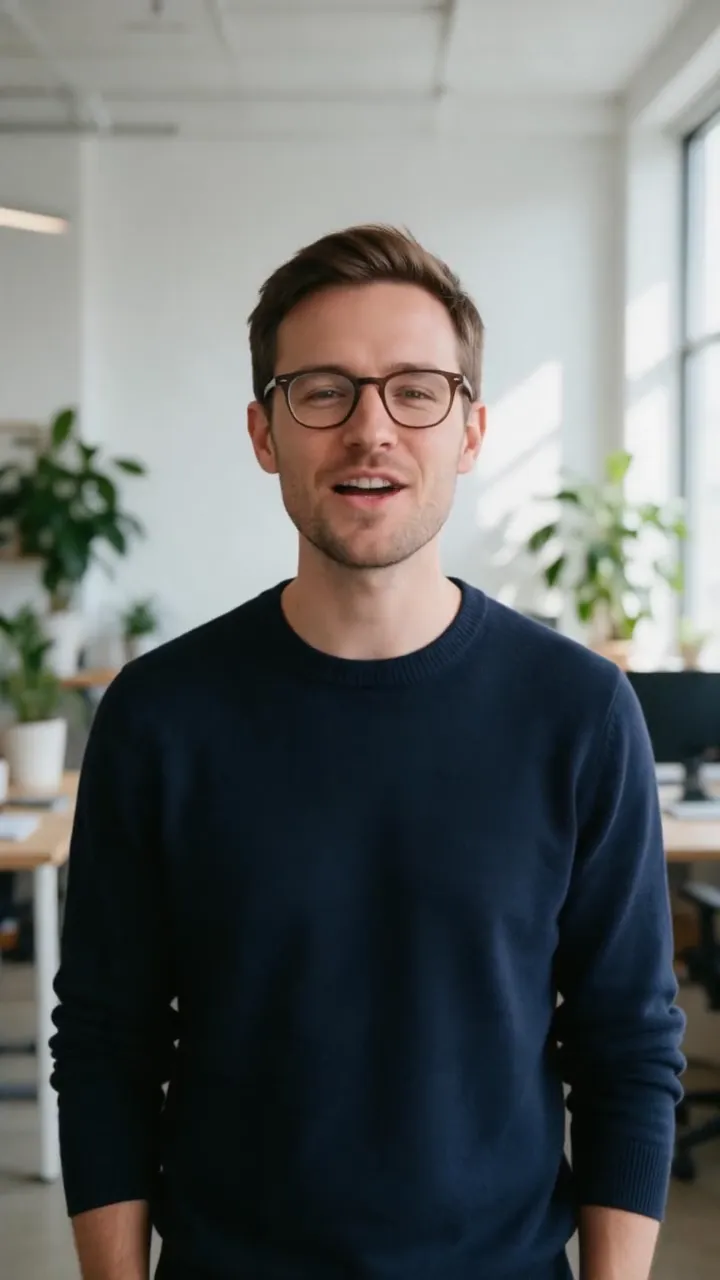
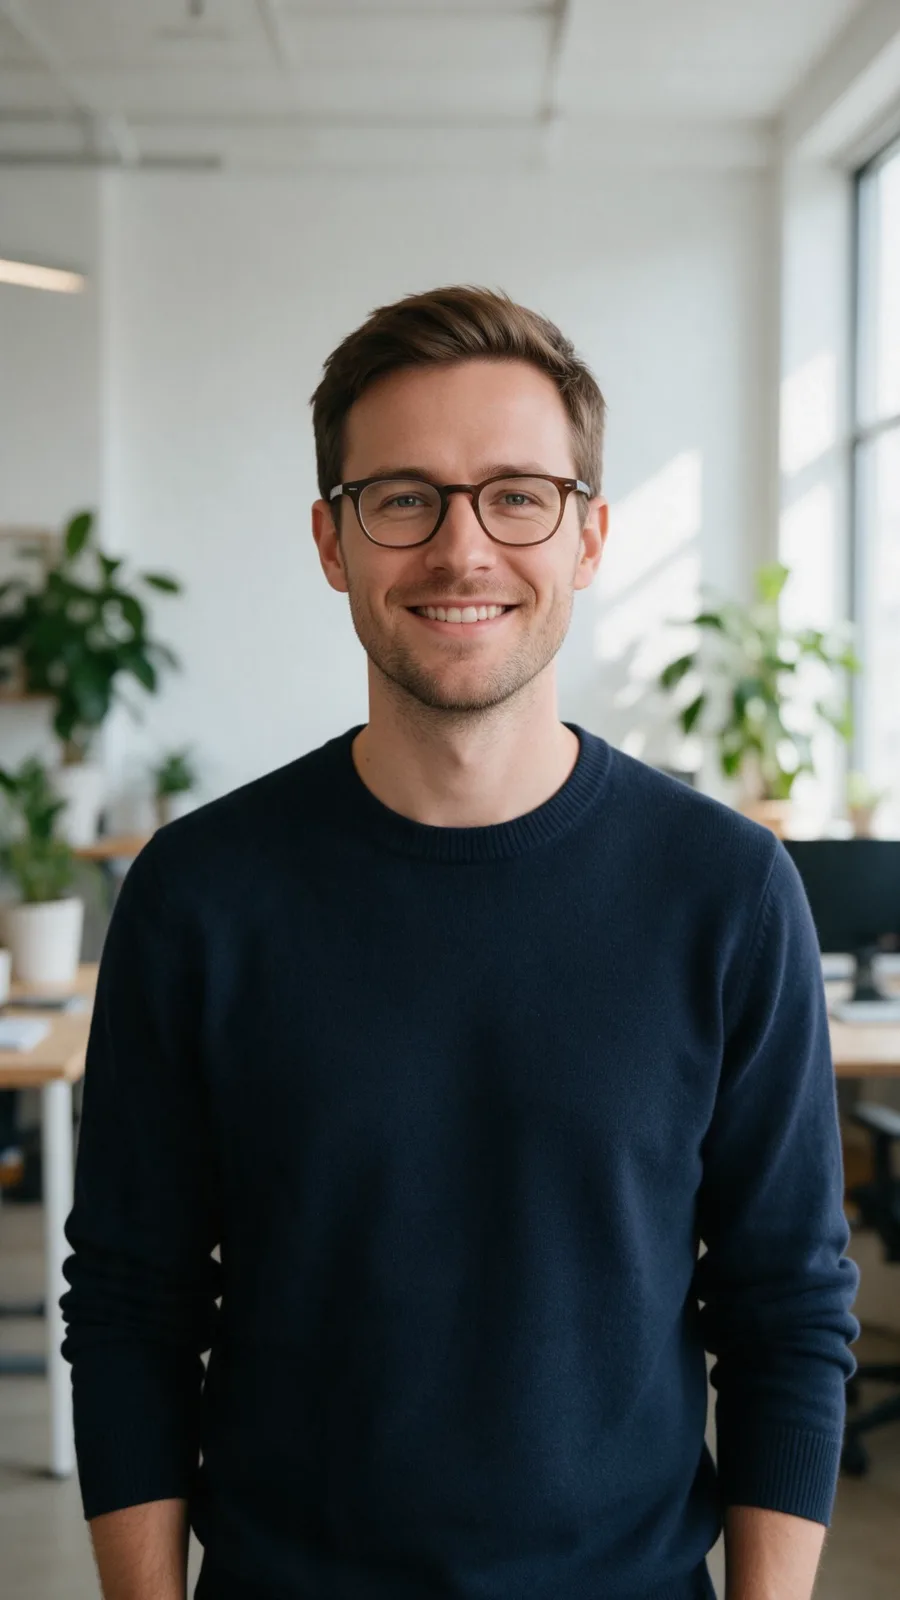
Приветствие для новичков: мужчина в очках и тёмно-синем свитере встречает нового коллегу и рассказывает о первой неделе
Онбординг9:16
Исходный портрет: мужчина в очках и тёмно-синем свитере в светлом открытом офисе
Исходное фото
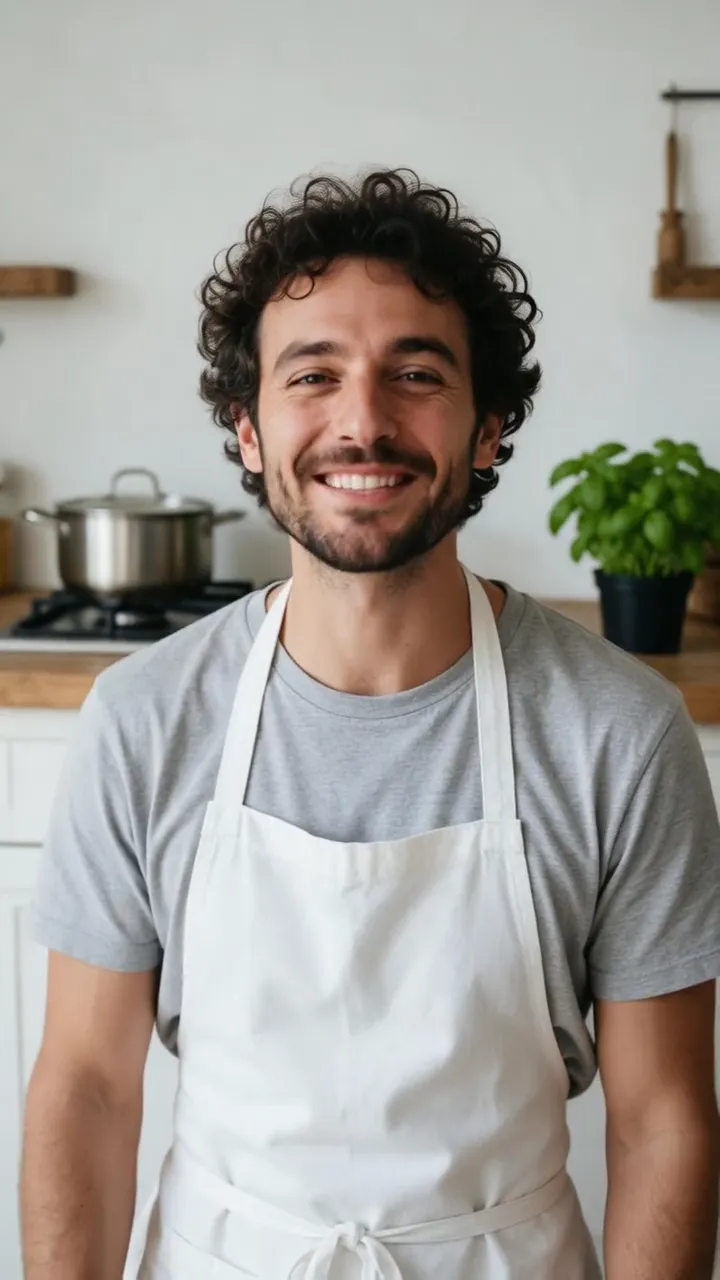
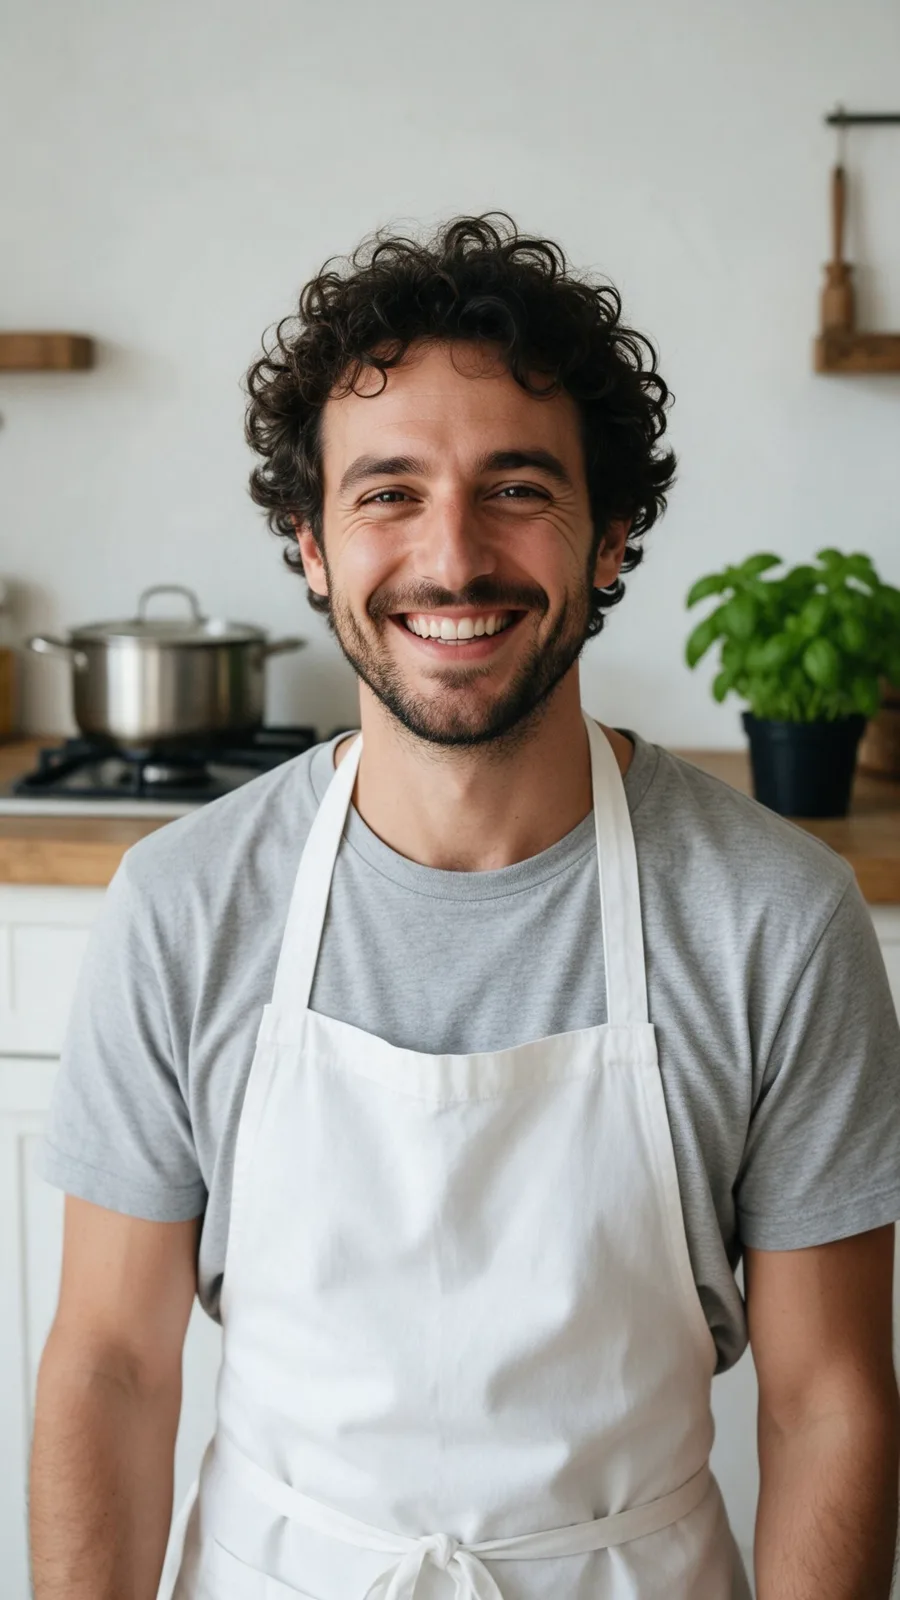
Мужчина с тёмными кудрявыми волосами в белом фартуке у плиты раскрывает по-итальянски секрет идеальной пасты
Итальянский9:16
Исходный портрет: мужчина с тёмными кудрявыми волосами в белом фартуке на деревенской кухне с базиликом
Исходное фото
Столяр в кожаном фартуке рассказывает о своей мастерской
Третий голос9:16
Исходный портрет: столяр в кожаном фартуке
Исходное фото

Полный цикл ИИ-видео

Голос остаётся. Видео строится вокруг него.

Утверждённый голос звучит ровно так, как записан. Отрендерите его с новым ведущим или в другом формате в Video Studio, сделайте из него субтитры SRT в Audio Studio, обрежьте ролик и добавьте заголовок в Video Editor, а готовое видео переведите в DUB.

  • Ваш файл ElevenLabs без изменений
  • Ведущий Hedra, OmniHuman или HeyGen
  • Субтитры из того же аудио
  • Все результаты сохраняются в Lab
Озвучить аватара

Вопросы перед созданием

Прежде чем загрузить голос

VlogMe связан с ElevenLabs?

Нет. ElevenLabs — независимая компания и товарный знак. Audio Studio VlogMe использует голоса ElevenLabs как провайдера, а этот сценарий также принимает аудио, экспортированное из вашего аккаунта ElevenLabs.

VlogMe меняет голос?

Нет. Говорящий аватар следует темпу и звучанию загруженного аудио.

Можно использовать клонированный голос?

Только с разрешения владельца голоса и с соблюдением условий провайдера и применимого законодательства.

Какие аудиофайлы можно загрузить?

MP3, WAV или M4A до 50 МБ. Hedra Avatar принимает до десяти минут аудио на одно видео, OmniHuman 1.5 и HeyGen Avatar V — до 60 секунд.

Работает с другими голосовыми сервисами?

Да. Подойдёт любая чистая запись речи — из другого синтезатора, подкастного микрофона или телефона.

Сколько стоит такое видео?

Кредиты списываются за секунду вашей дорожки из ElevenLabs по ставке выбранной модели аватара, а загрузка готового голоса ничего не стоит. Бесплатного тарифа нет: купите кредиты, когда будете готовы, — студия покажет оценку до рендера.

Голосовая дорожка готова

Дайте голосу лицо.

Выберите голосовую дорожку и портрет здесь — аккаунт пока не нужен. Войдите, когда продолжите: оба файла загрузятся в Lab и откроются в Talking avatar, а расчёт кредитов вы увидите до рендера.

  • Без съёмочной группы
  • Голос не меняется
  • Экспорт для любой площадки

Оценка в кредитах до генерации · Кредиты — только когда они нужны