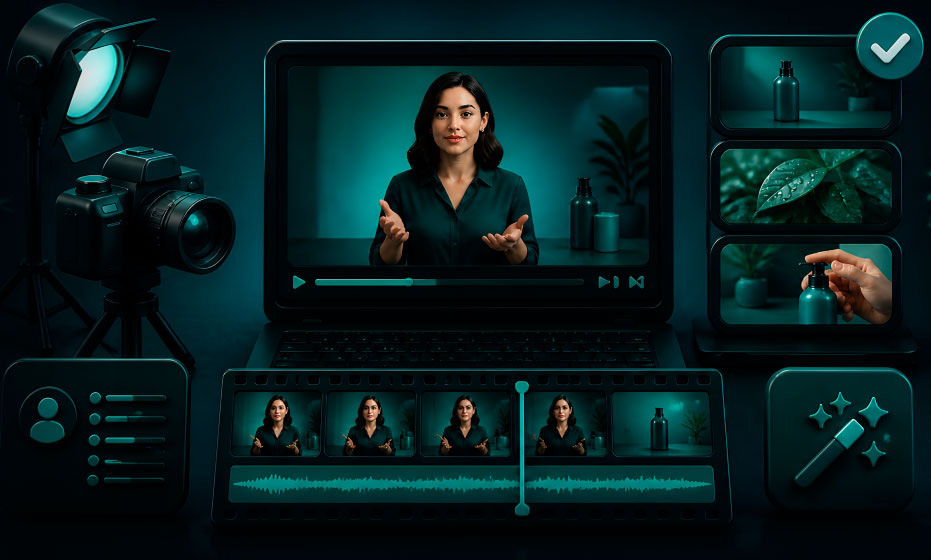
口播视频是一个人或一个数字人直接对着镜头说话的视频,通常是胸部以上的构图,一个声音,剪辑很少。面孔和声音比幻灯片或录屏更快地传达观点,所以它是教程、课程、销售沟通、创始人动态和社交媒体讲解视频最常用的形式。
AI 口播生成器消除了拍摄、重拍、布光与剪辑的瓶颈——同一个脚本可以用多种语言、由不同主持人发布,无需预约任何一次拍摄。
好的口播视频靠什么
- 第一句话。 先说清楚为什么值得看下去,再做自我介绍。
- 构图。 胸部以上,眼睛大约在画面上方三分之一处,脸上光线均匀。竖屏 9:16 能占满手机屏幕,16:9 在 YouTube 和网站上能留出放标题的空间。
- 声音比画面重要。 观众能容忍普通的画面,却很难忍受发闷的声音,所以干净的人声比相机更重要。
- 字幕。 很多人静音观看,关掉声音时由字幕传达内容。
- 时长。 Shorts、Reels 和 TikTok 为 15–60 秒;教程或产品讲解为几分钟。
在 VlogMe 中不用相机制作
口播视频可以从一张肖像开始。在图片转口播视频中上传肖像,写好脚本,在 Audio Studio 中生成语音或上传自己的录音,再以 9:16、1:1 或 16:9 渲染。Hedra Avatar 和 OmniHuman 1.5 让您的图片动起来,HeyGen Avatar V 则用它自己的预设主持人说出您的音频。同一位主持人之后可以说下周的脚本,也可以换语言、换画幅。面向产品和销售的内容,请看 AI 品牌代言人页面,那里用品牌主持人演示了同样的流程。
限制与风险
- AI 主持人会一字不差地说出您写的内容:先把脚本读出声,删掉您自己不会说的句子。
- 同一个固定镜头里的长篇独白容易让人疲劳;把长脚本拆成章节,或穿插产品画面。
- 面孔和声音必须是您本人的、虚构角色的,或已获得许可;平台或法律有要求时,请标注主持人由 AI 生成。
常见问题
口播视频和会说话的数字人是一回事吗?
不是。口播是一种形式:一个人对着镜头说话。会说话的数字人是不用拍摄就能做出这种视频的一种方法。
需要麦克风吗?
如果用 AI 主持人就不需要:TTS 或克隆声音可以代替录音。如果您自己出镜,一个普通的领夹麦克风比换更好的相机更能提升效果。
选哪种画幅?
Shorts、Reels 和 TikTok 用 9:16,信息流用 1:1,YouTube、课程和网站用 16:9。