播客视频制作 将照片与播客音频变成视频
为纯音频节目加上看得见的主持人:用一张肖像和一段精华音频,生成适合社交媒体的播客视频。
- 通过 Google 或邮件链接登录
- 继续之前,文件保留在本地
- 生成前查看积分预估
 上传主持人照片
 添加播客片段
 设定画面
 渲染节目
01节目开场
可观看的音频节目
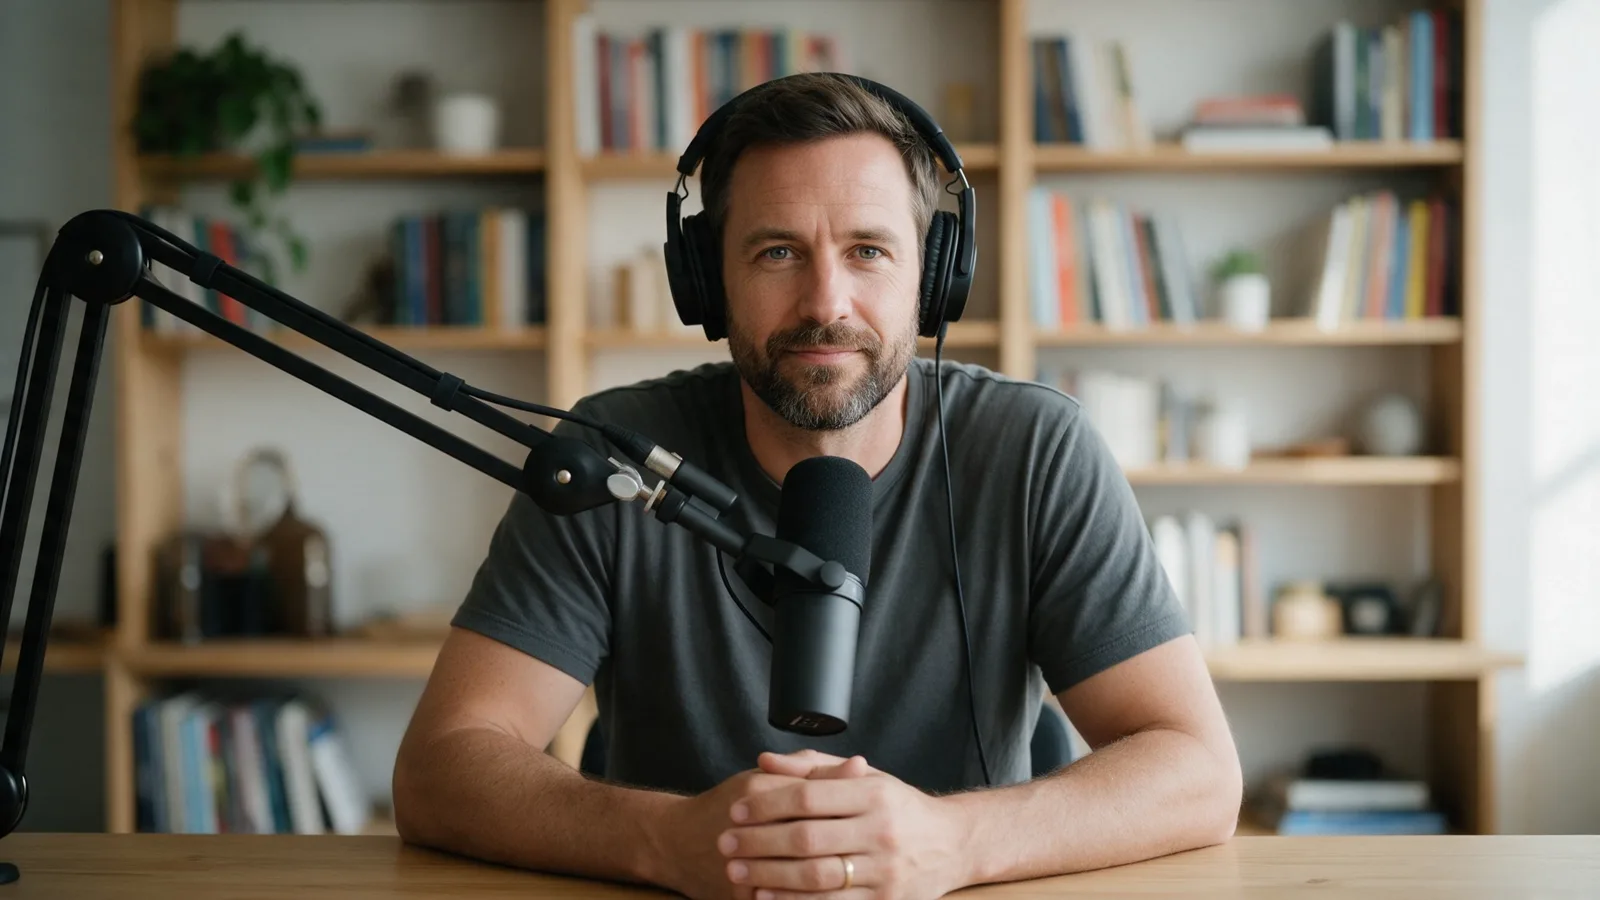
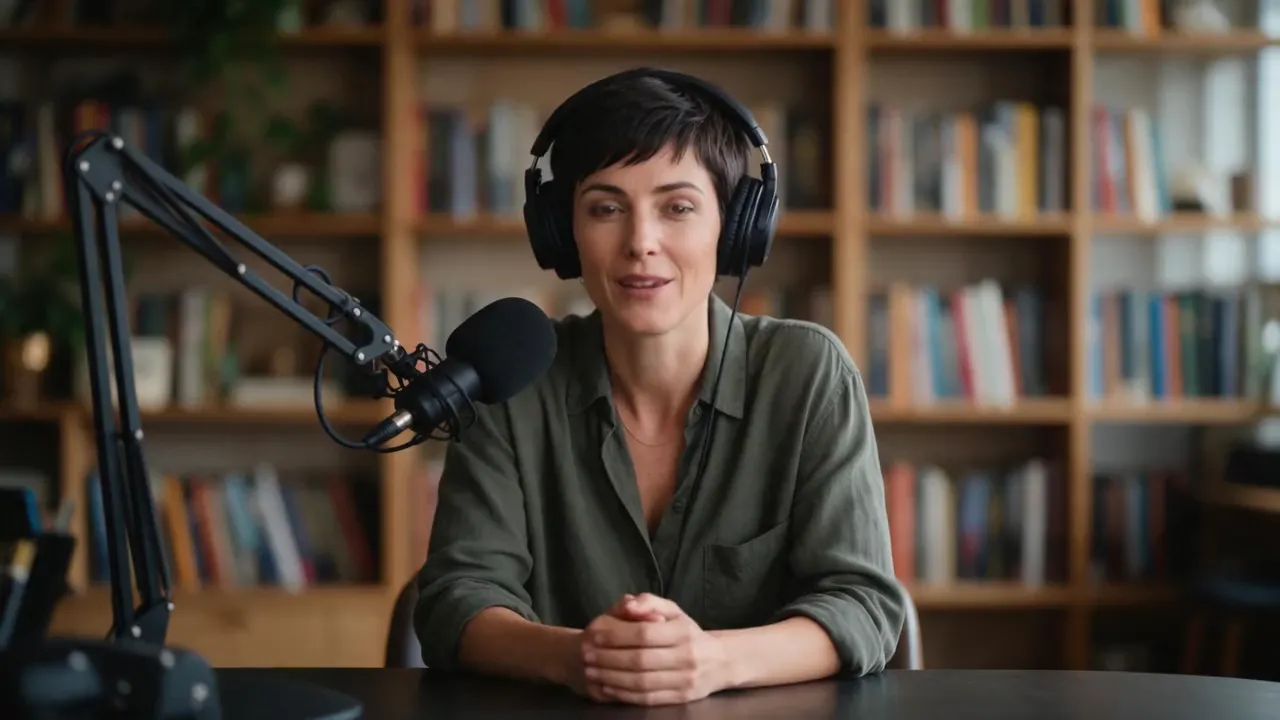
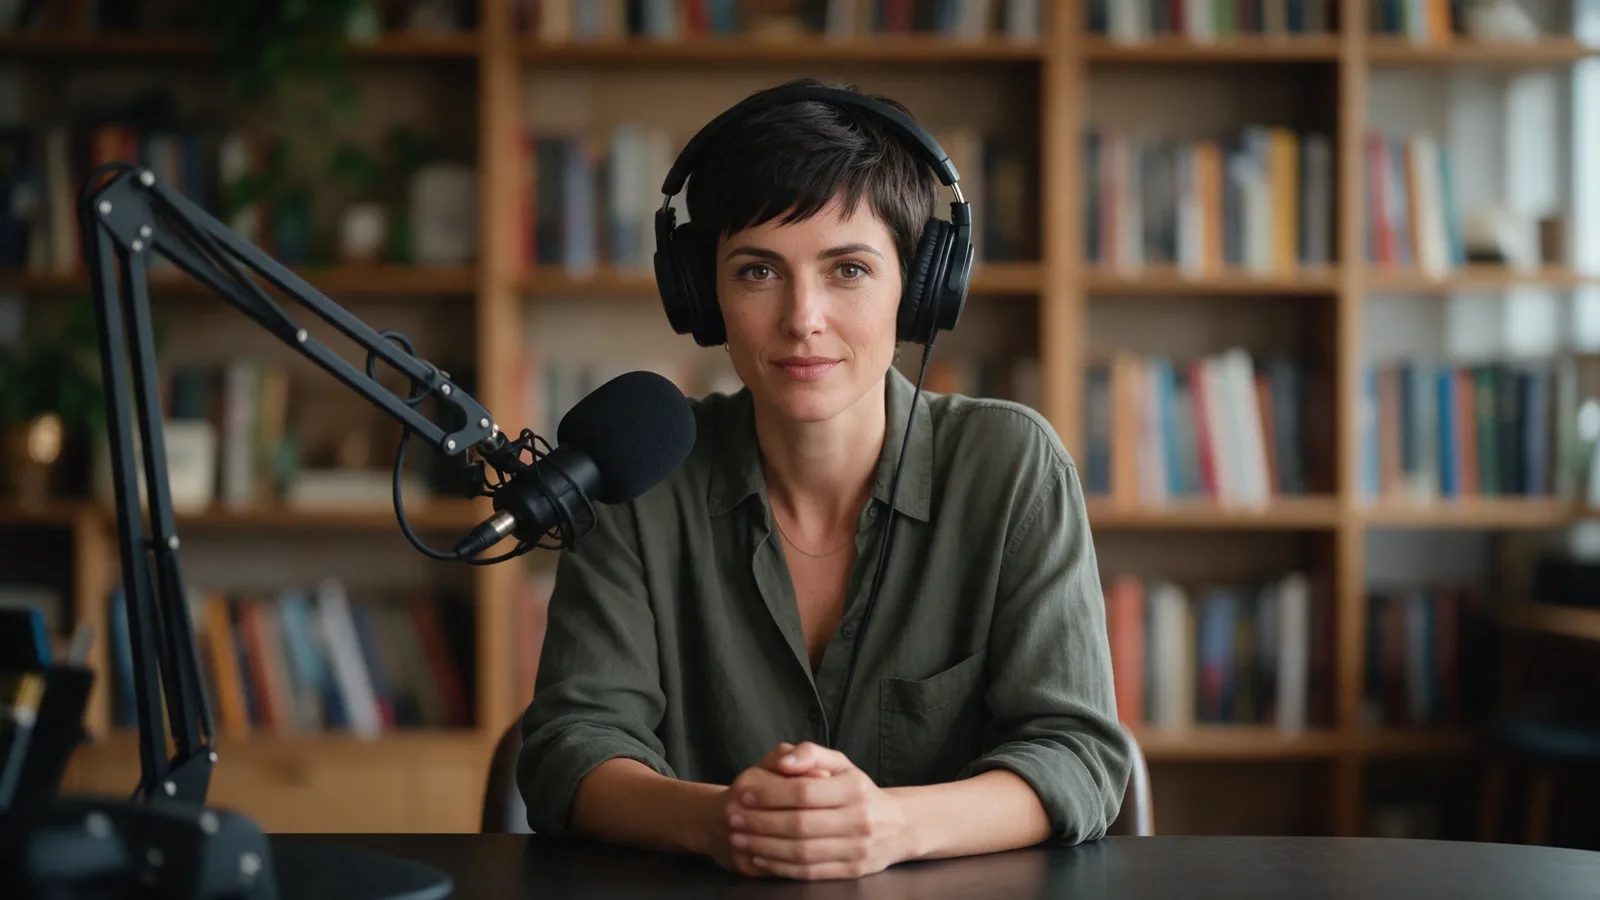
这位坐在录音话筒前的大胡子主持人,来自一张生成的肖像和一段用 ElevenLabs 配音的节目开场白。Hedra Avatar 以 16:9 渲染,正是 YouTube 播客的常见画幅。
- 口型同步跟随真实的节目音频
- 把精华片段做成 9:16 社交短视频
- 可用主持人、嘉宾肖像或插画角色
- 原声与节奏完整保留
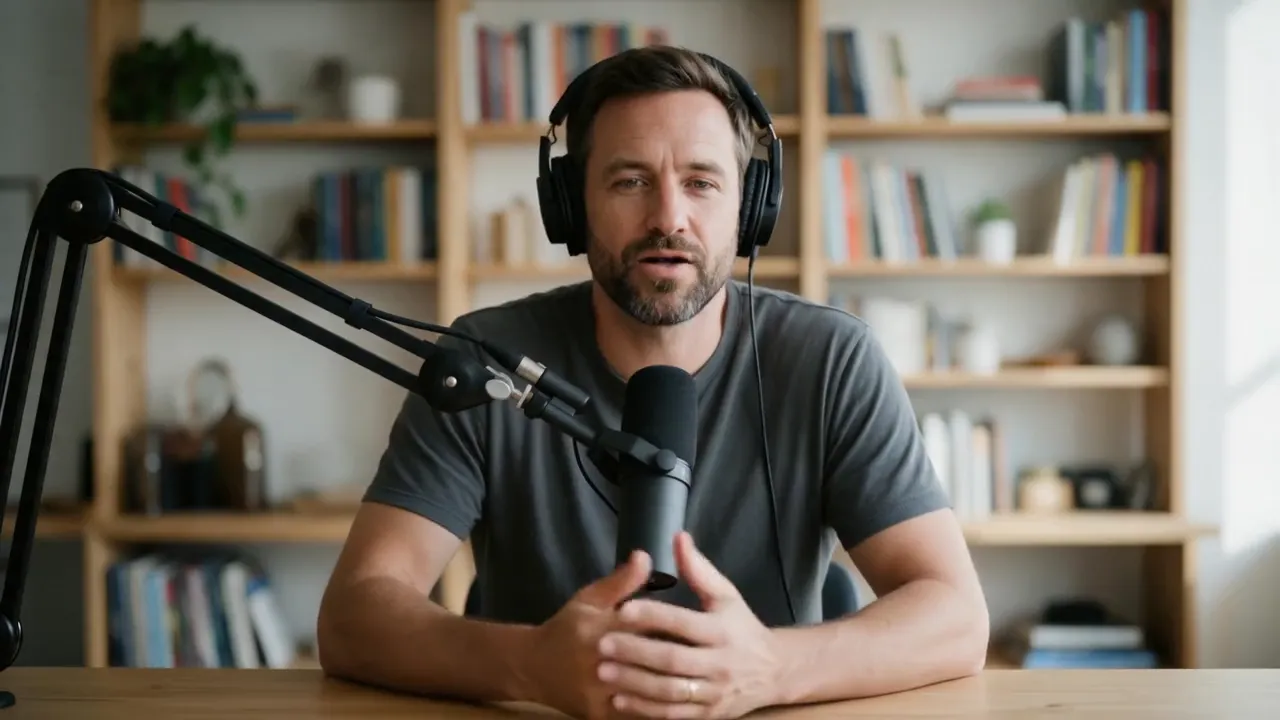 Hedra Avatar · 16:916:9
03使用方法
从播客片段到视频,只需三步
选择出镜主持人
上传一张清晰的主持人或角色肖像。
选择节目片段
15–90 秒的精选片段最适合在社交平台传播。
生成视频片段
数字人按原始音频演绎,之后即可加字幕并导出。
- 主持人照片
- 节目音频
- 16:9 节目
- 9:16 短片
- 字幕
成片示例
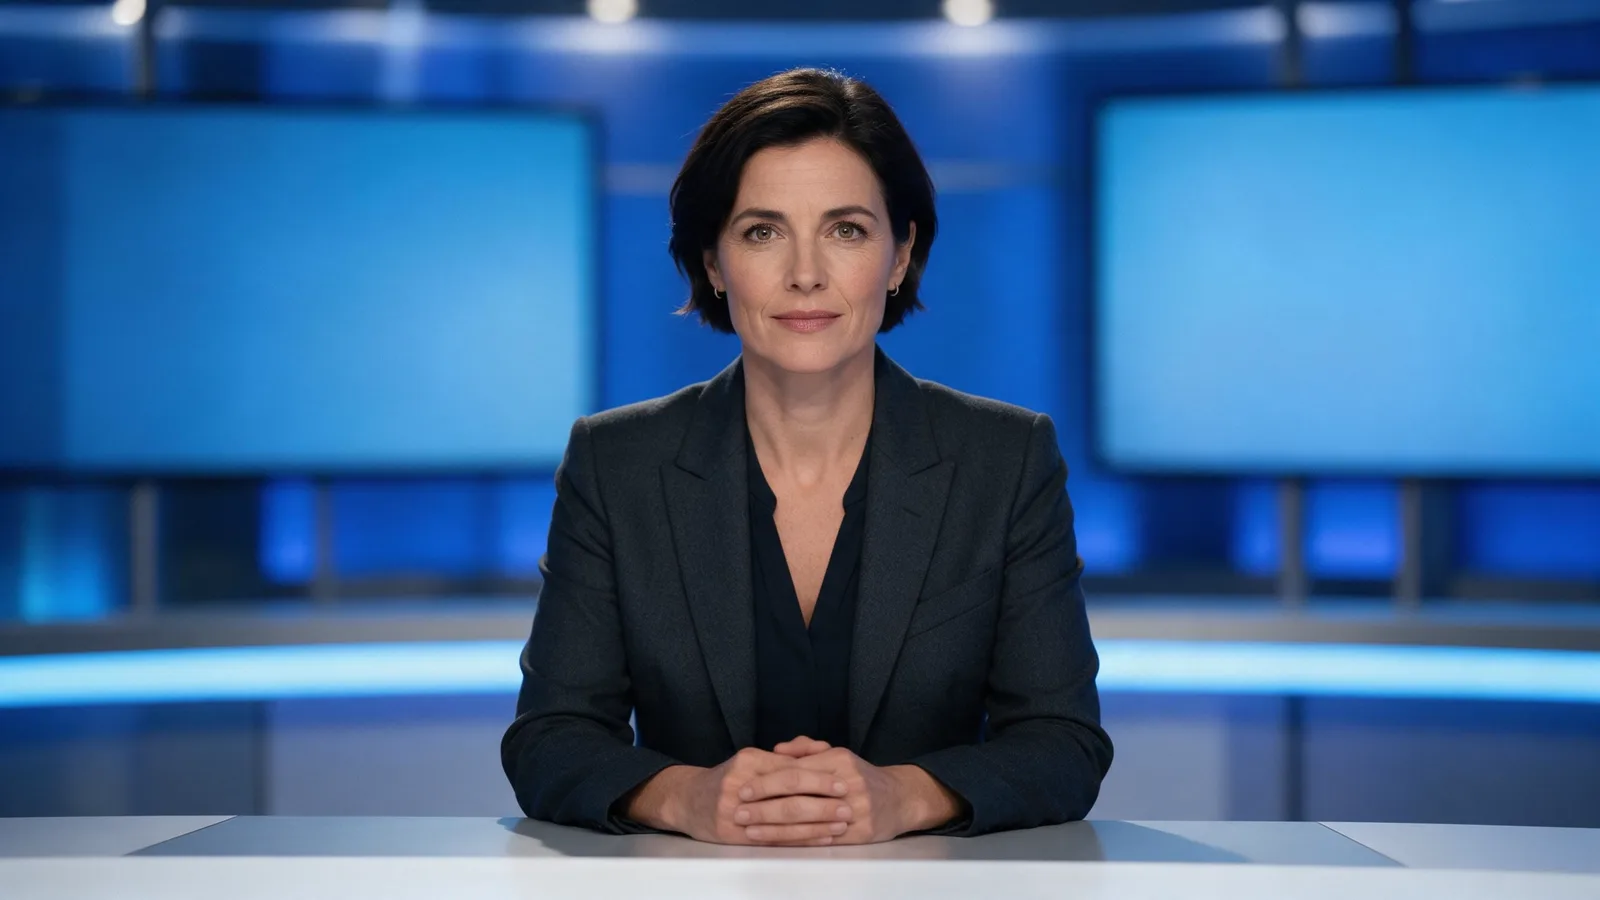
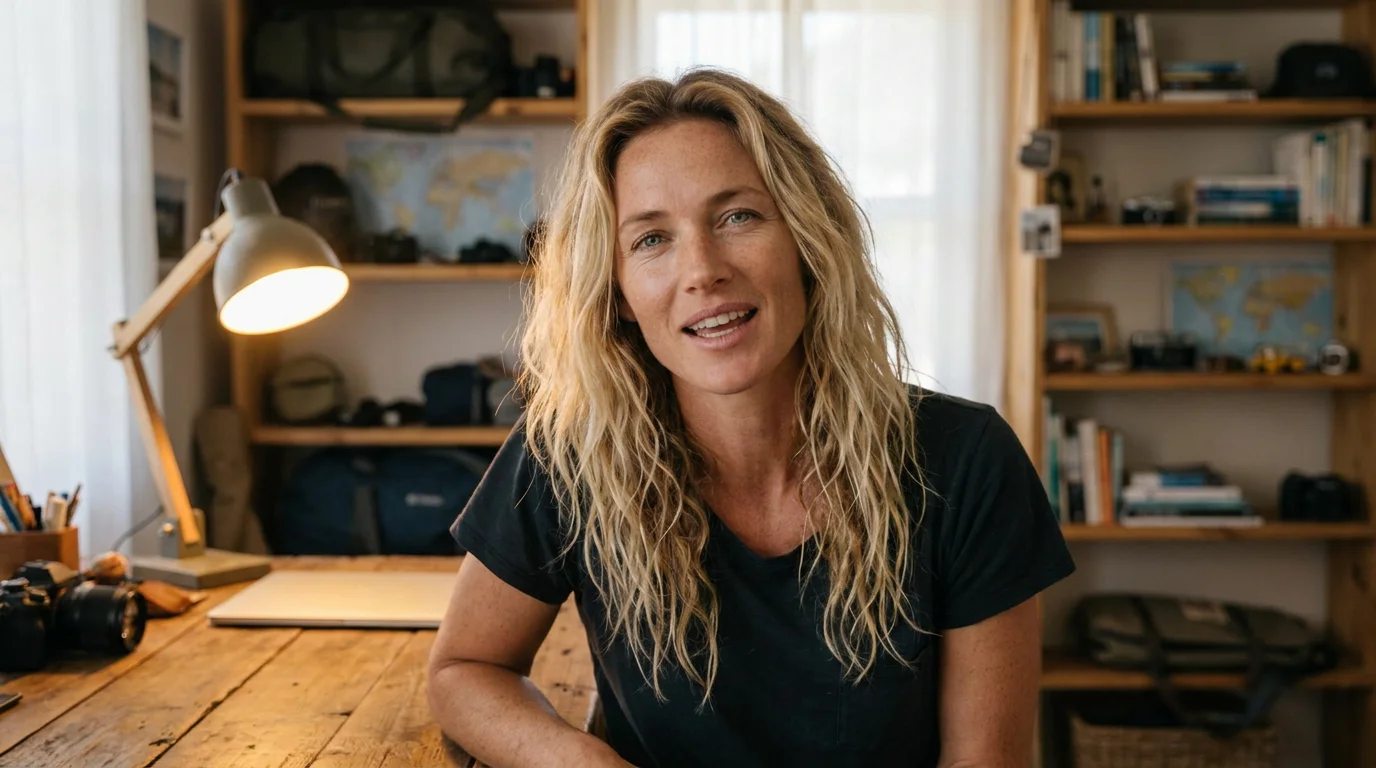
早间简报、相机测评、分数课
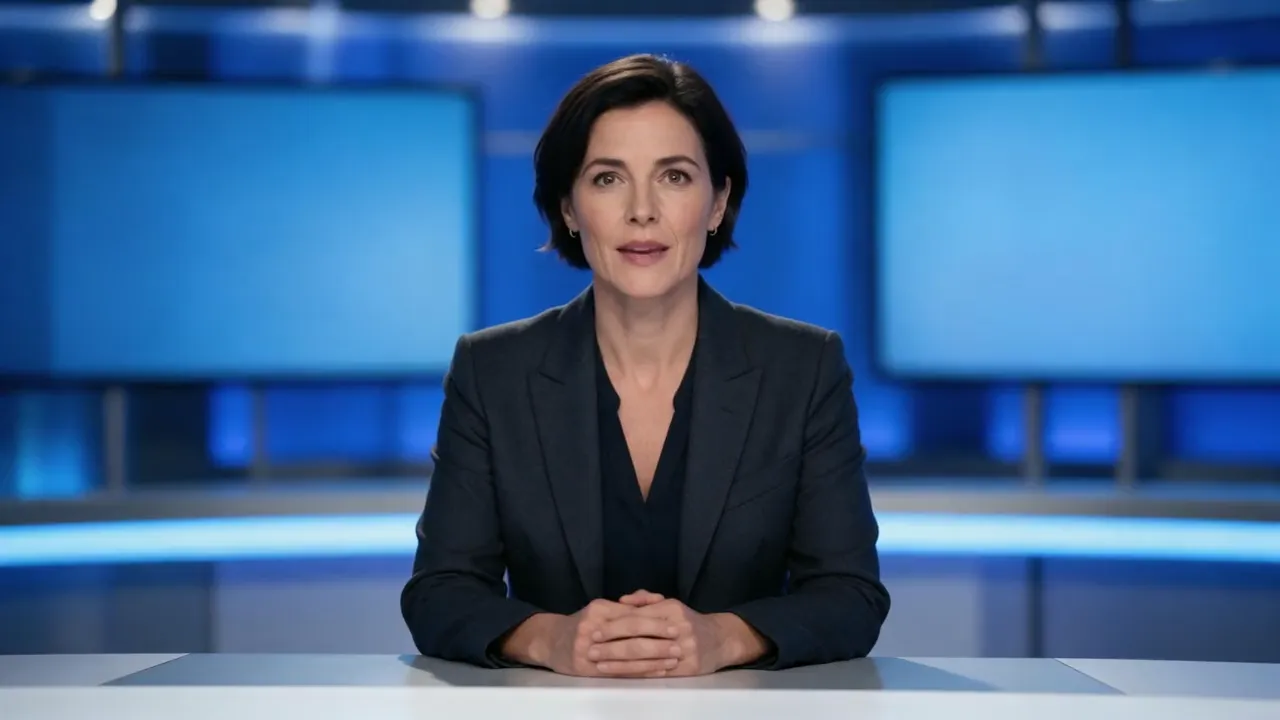 简报 · 16:916:9
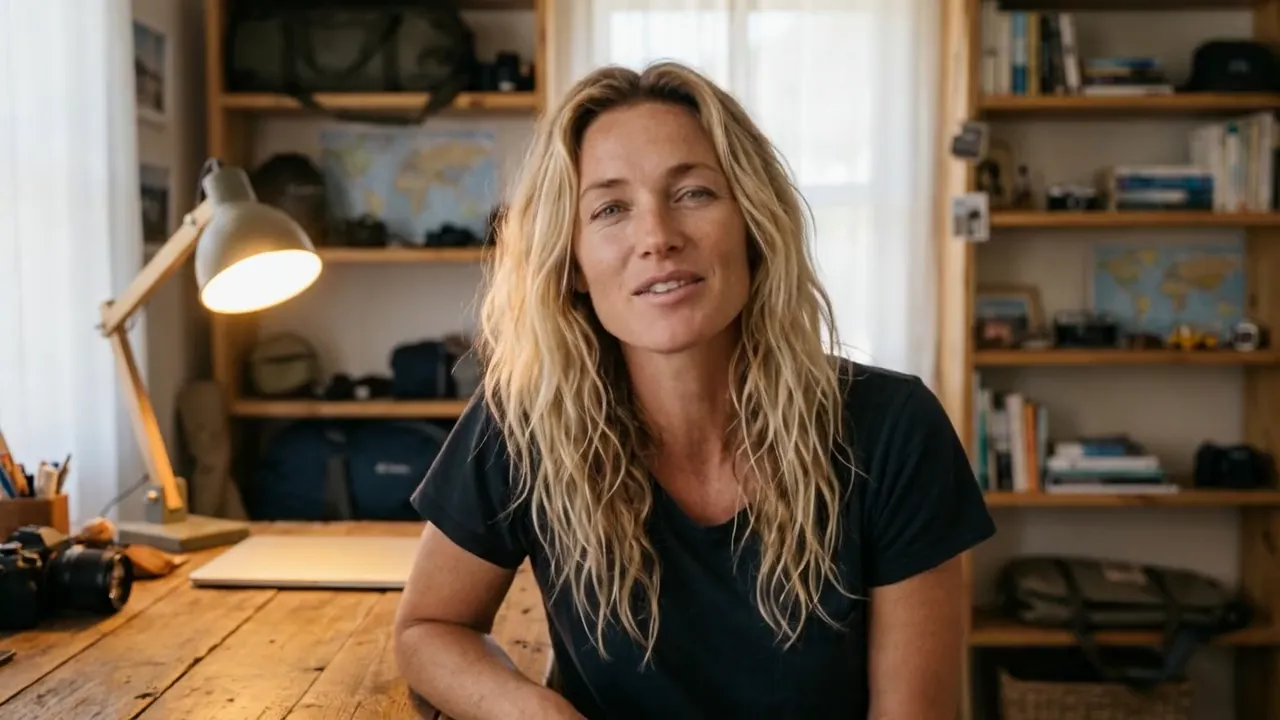 相机测评 · 16:916:9
 课堂 · 16:916:9
完整 AI 视频创作
每一期节目,也是一期视频。
主持人照片保存在 Lab 中,新片段一出来就能渲染。在 Audio Studio 清理人声并生成 SRT 字幕,在 Video Editor 裁剪、加标题,面向其他市场时用 DUB 翻译。
- 用照片生成主持人与联合主持
- 16:9 节目、9:16 短片
- 用音频生成 SRT 字幕
- 所有片段保存在 Lab
创建前的问题
节目变成视频之前
会改变播客的声音吗?
不会。数字人口播流程完全跟随你提供的音频文件。
片段多长合适?
简短的社交精华片段更好看,渲染也更快。较长的音频可以拆成多个片段。
可以加字幕吗?
可以。在 Audio Studio 中用同一段音频生成 SRT 或 VTT 字幕,或用 Video Editor 把简短标题压进视频。
可以让嘉宾或联合主持出镜吗?
可以。每位说话人都用各自的照片和音频片段渲染,按人或按发言各做一条。
单条片段最长多久?
Hedra Avatar 每条最长 10 分钟,OmniHuman 1.5 最长 60 秒。如需把节目分成多个场景,可以用 Director 制作最长 3 分钟的视频。
播客视频怎么收费?
按节目音频的秒数消耗积分,截取的片段越长越贵,所以渲染前只保留想发布的部分。生成需要付费,在 Director 中规划在使用额度内免费:准备好后再购买积分,渲染前工作室会显示预估。