 1:1 · 同一声音1:1
01任意画幅
同一条素材,方形版直接发信息流。
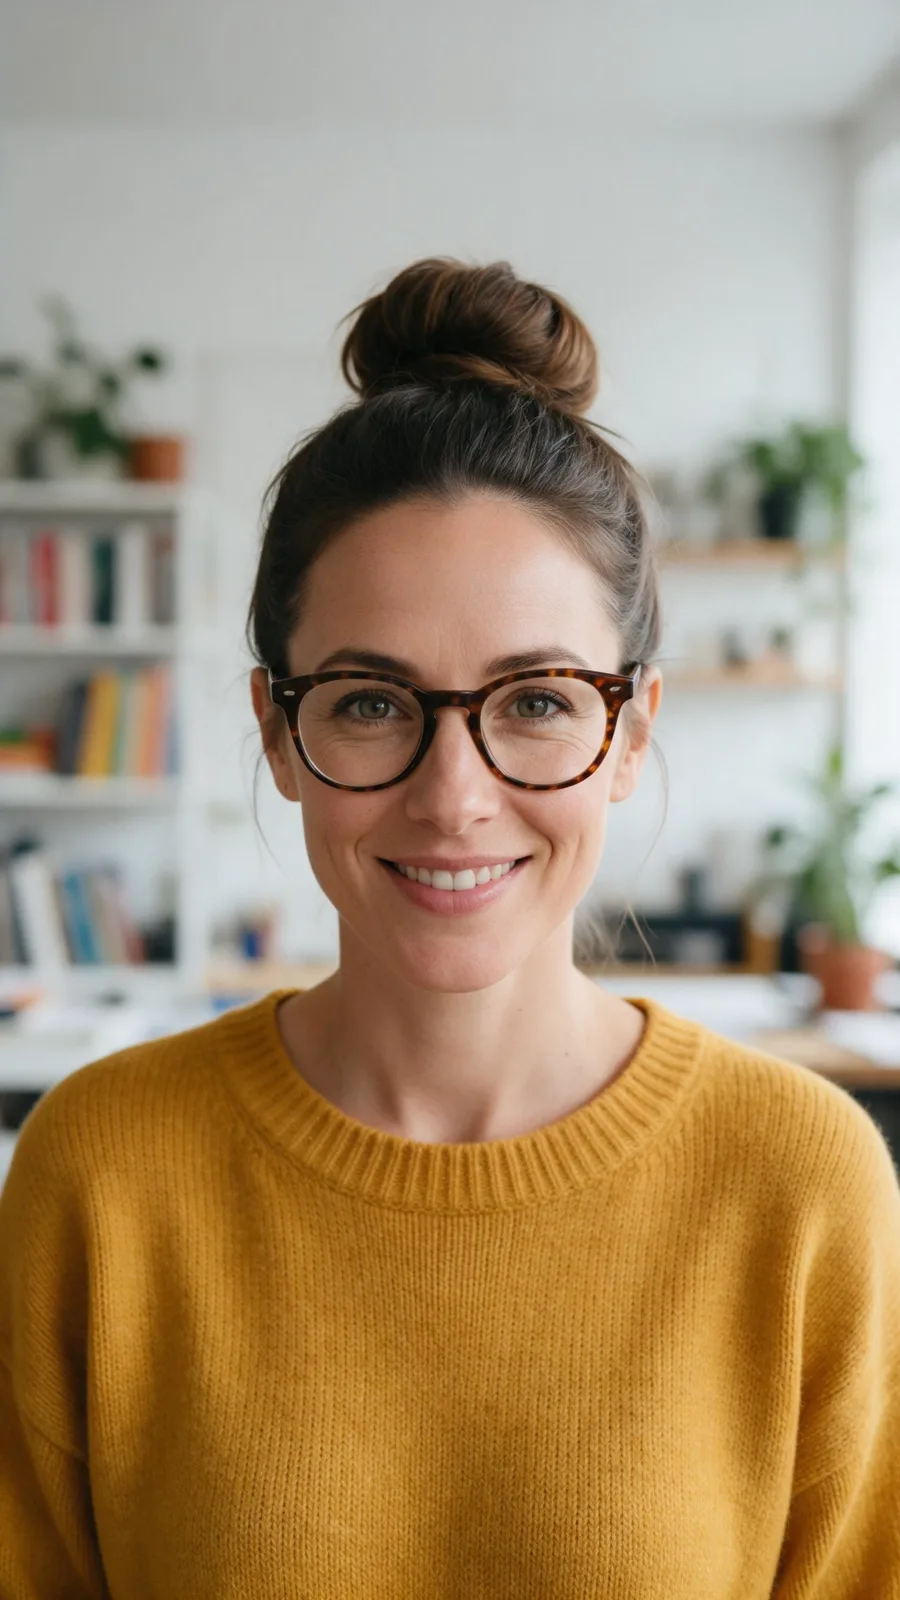
这是上方示例同一张照片、同一条配音,以 1:1 重新渲染的结果。Hedra Avatar 同样支持 9:16 和 16:9,一个主持人就能覆盖 Reels、信息流和频道,无需新照片,也不必重新录音。
将肖像、插画或品牌角色变成可以反复出镜的主持人,用于社交视频、讲解、培训和产品更新,无需拍摄。
 上传肖像
 添加脚本或配音
 选择模型与画幅
 生成并复用
01一张照片生成
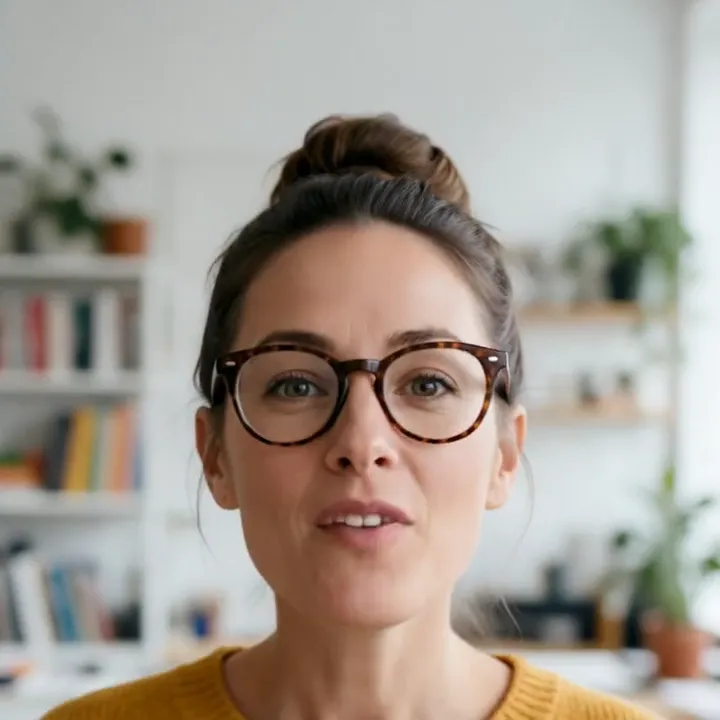
这位主持人最初只是一张生成的肖像。借助 Audio Studio 里的 ElevenLabs 配音和 Hedra Avatar,它变成了会说话的视频——没有摄像机,也没有演播室。照片保持不变,每条视频的脚本、声音、语言、字幕和画幅都可以更换。
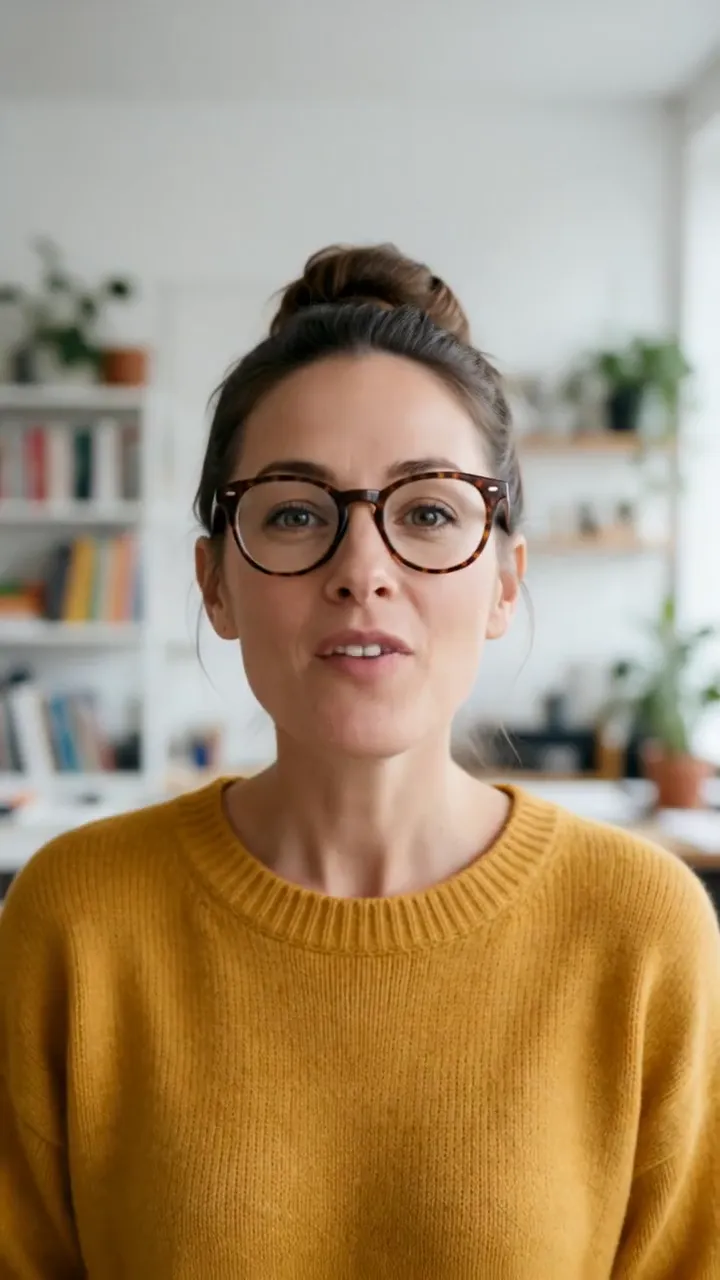 Hedra Avatar · 9:169:16
02先展示,再说明
1:1 · 同一声音1:101任意画幅
这是上方示例同一张照片、同一条配音,以 1:1 重新渲染的结果。Hedra Avatar 同样支持 9:16 和 16:9,一个主持人就能覆盖 Reels、信息流和频道,无需新照片,也不必重新录音。
 Español9:16
02多种语言
我们用西班牙语写好台词,在 Audio Studio 里用同一个 ElevenLabs 声音生成配音,再由 Hedra Avatar 让口型对上新台词。已经做好的视频,可以交给 DUB 翻译。
03任意主持人
创始人照片、插画吉祥物或生成的角色都可以,只要眼睛和嘴巴清晰。Hedra Avatar 和 OmniHuman 1.5 会让你上传的图片动起来;HeyGen Avatar V 则由它的一位预设主持人演绎你的音频,不使用你的照片。
03使用方法
上传你拥有使用权的肖像或角色;也可以不用照片,直接选用 HeyGen Avatar V 的一位预设主持人。
粘贴脚本并在 Audio Studio 中生成配音,或上传已有录音。视频时长与音频一致。
选择模型与画幅,确认积分预估后渲染,下一条视频继续使用同一张肖像。
成片示例
绿植小贴士、西班牙语跑步入门、骑行通勤广告
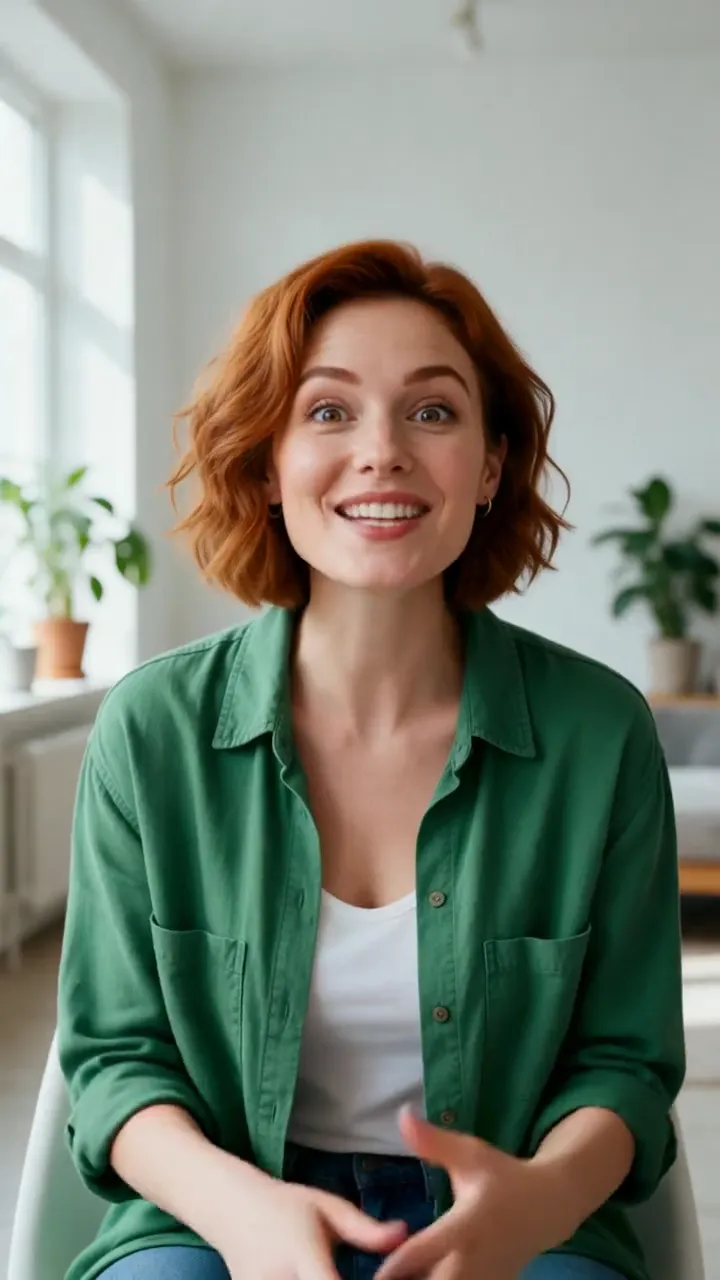 创作者9:16
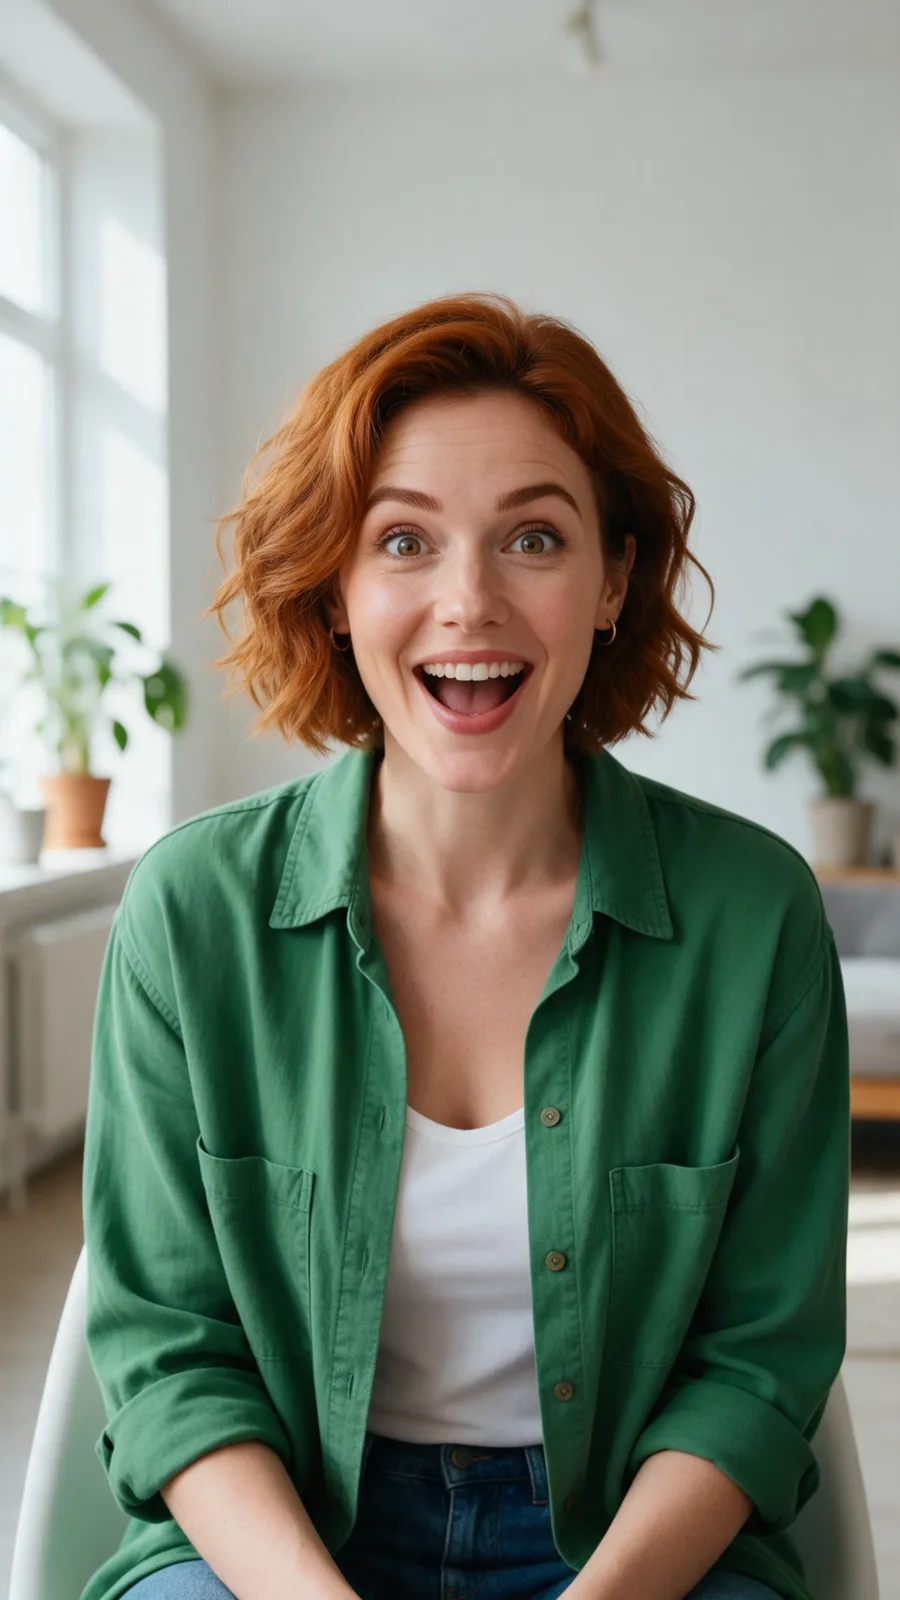
 西班牙语9:16
 广告9:16
完整 AI 视频创作
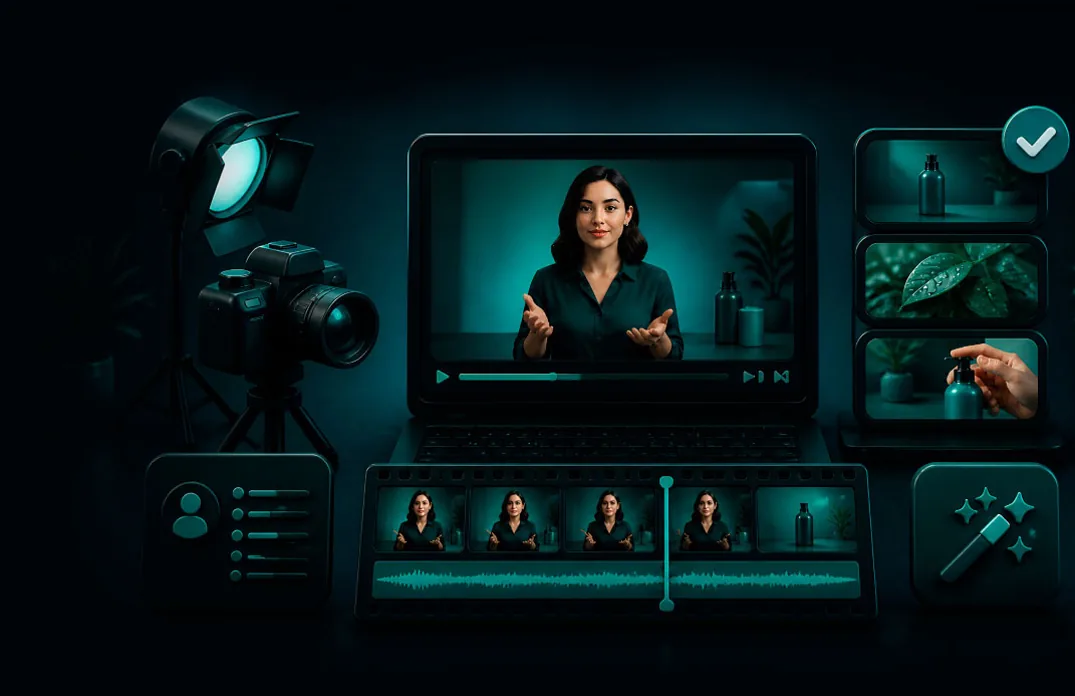
肖像保存在 Lab 中。下周写好新脚本,在 Audio Studio 生成配音,在 Video Studio 输出其他画幅,在 Video Editor 裁剪或加标题;也可以把成片交给 DUB,翻译成其他语言。
创建前的问题
可以使用清晰的肖像、插画、绘画或生成角色,但你必须拥有相应素材,或已获得动画化许可。
可以。保持肖像和声音一致,同时更换脚本、语言、字幕与画幅。
可以。上传录音,或在 Audio Studio 中用你有权使用的 20–60 秒样本克隆自己的声音,然后用于任何脚本。
Hedra Avatar 以稳定的口型同步驱动你的肖像,支持 9:16、1:1 和 16:9。OmniHuman 1.5 的头部和身体动作更丰富,并保留原图构图。HeyGen Avatar V 则由它的一位预设主持人演绎你的音频,不使用你的照片。想了解 VlogMe 与专门的数字人平台有何不同,请阅读VlogMe 与 HeyGen 对比和VlogMe 与 D-ID 对比。
不需要。先准备一张你有权使用的图片和脚本,再在编辑器中选择或上传声音。
数字人视频按积分计费。在 Director 中规划视频可以免费开始,包括脚本、图片、配音和音乐,均在使用额度内;准备渲染时再购买套餐或积分包,渲染前工作室会显示积分预估。从本页继续时,请使用 Google 或邮件链接登录。
一张照片就能开始
在这里选择肖像、写好台词,然后登录即可继续:肖像会上传到 Lab 并在 Talking avatar 中打开,台词可直接生成配音,渲染前即可查看积分预估。之后的每条视频都能继续使用同一个数字人。
生成前显示积分预估 · 需要时再购买积分