口型同步把声音和面部动作对应起来。模型先从语音中提取音素序列(/a/、/b/、/th/ 等最小语音单位),再为每个音素匹配对应的口型(视素),并逐帧重新生成面部。
好的口型同步不只看嘴形,还要兼顾下颌开合、舌头是否可见、嘴唇圆展以及自然停顿;做得不好的同步会让嘴部像橡胶一样不自然,或在没有声音时嘴还在动。
两种口型同步
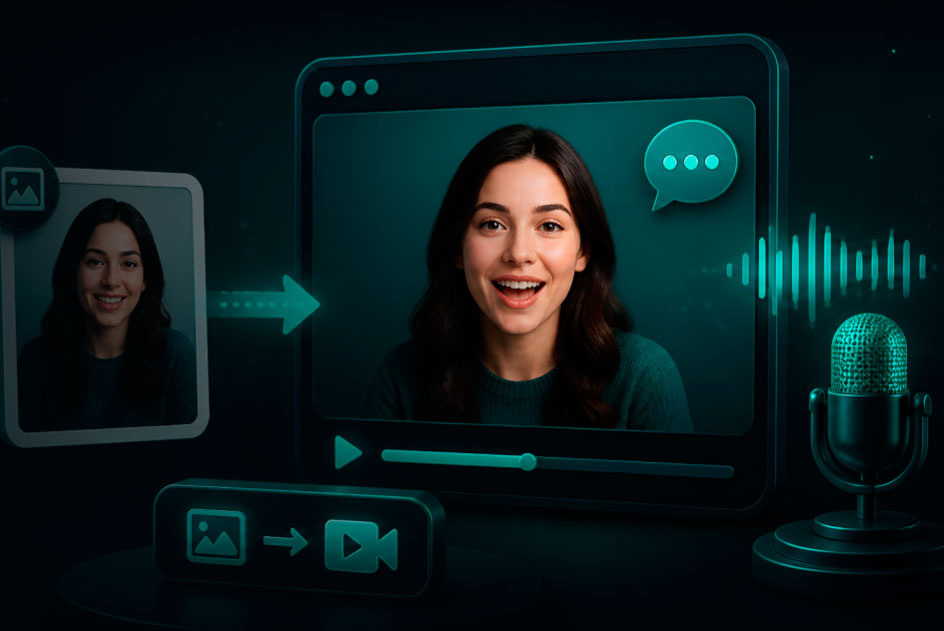
基于照片的口型同步从一张静态肖像和一条语音开始,由模型生成完整的说话表演:嘴、下颌、眨眼和轻微的转头。会说话的数字人和会说话的照片都是这样做出来的——这张脸从未被拍到说话。
基于已有视频的口型同步保留拍好的表演,只重绘嘴部区域,使其与新的音频一致:翻译后的台词、改正后的产品名称、一条更好的录音。身体、背景和运镜都保持原样,所以当新台词与原台词长度相近时,几乎看不出修改。
在 VlogMe 中进行口型同步
两种方式都在 Video Studio 中完成。
- 想让照片开口说话,可使用让照片说话:一张肖像加一条语音,由 Hedra Avatar(最长 10 分钟)或 OmniHuman 1.5(最长 60 秒,动作更丰富)渲染。
- 想让已拍摄的视频重新对口型,可把原始片段和新音频交给 Lipsync 2 Pro。成片长度和价格以两者中较短的那个为准,所以请先剪好音频。
示例:一位创始人录好了 40 秒的产品更新视频,随后功能改了名字。她用新名称重新录一遍(或在本人同意下克隆自己的声音,在 Audio Studio 中配音),再把视频和新音轨交给 Lipsync 2 Pro。返回的片段里,她的口型说出的就是新名称,全程无需重拍。积分价格会在运行前显示。
如果要把整支视频改成另一种语言,先用 DUB 翻译并重新配音;再为配音后的音轨做口型同步,是 Video Studio 中单独的一步。
限制与风险
- 每一帧都需要看得到脸,并且大致朝向镜头;侧脸、手挡住嘴和快速转头都会破坏同步。
- 语音下面垫着音乐或人群噪声,会让口型变得含糊;干净的人声能带来清晰的发音。
- 新台词比原台词长很多时,身体仍按原来的节奏动作;请把台词改写成相近的长度。
- 改变真实人物看起来说出的话,需要本人许可,误导观众的修改是不允许的(服务条款第 5、6 节)。
常见问题
口型同步和配音是一回事吗?
不是。配音是把声音换成另一种语言,口型同步是让嘴部动作跟上声音。配音后的视频可以再做口型同步,让新台词看起来像是本人说的。
唱歌也能做口型同步吗?
可以,前提是人声清晰。尽量把人声和伴奏分开:人声下面的鼓和合成器会打乱口型。让照片唱歌就是为此设计的。
什么样的音频效果最好?
任何可以上传到 Lab 或在 Audio Studio 中生成的语音都可以。关键是只有一位说话人、声音清晰、下面没有音乐。