最适合
全身出镜的主持人、手势、表演、随音乐律动的角色和复杂构图。
ByteDance
顶级可用以积分计费,价格取决于音轨时长。运行前,Studio 会显示确切的积分价格。
全身出镜的主持人、手势、表演、随音乐律动的角色和复杂构图。
大批量低成本口播视频,或只需简单主持人的视频。
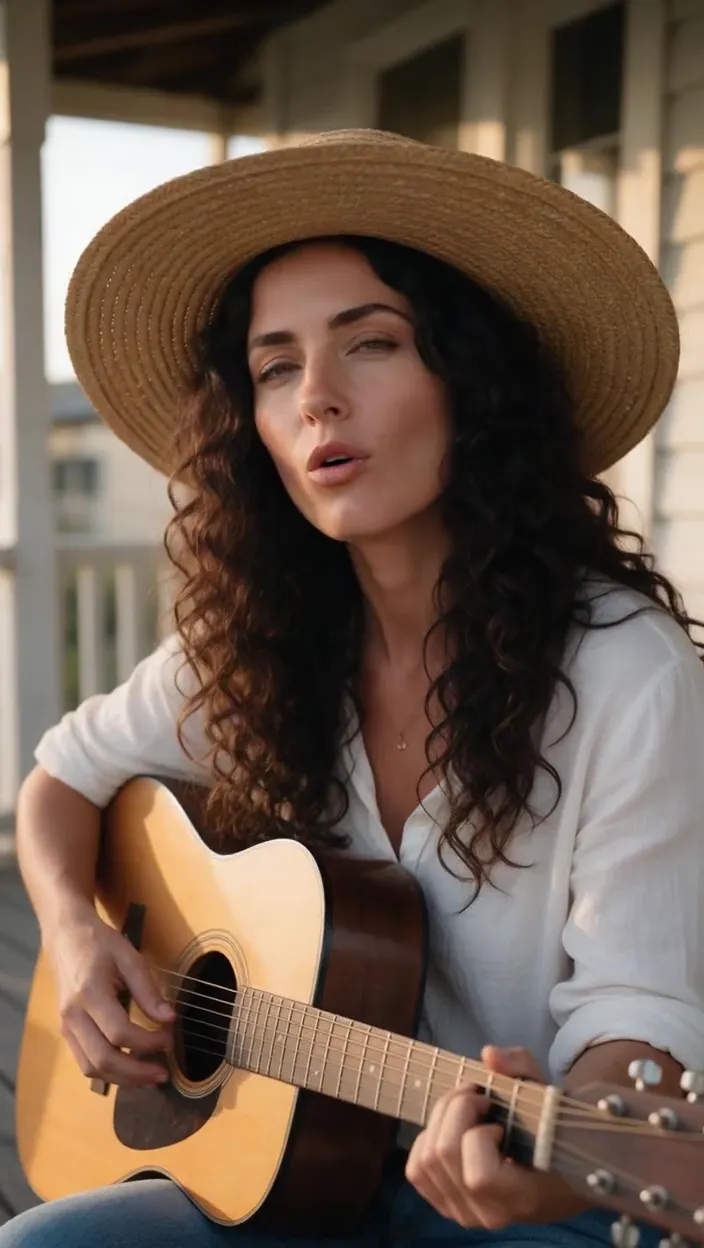 由 OmniHuman 1.5 生成9:16
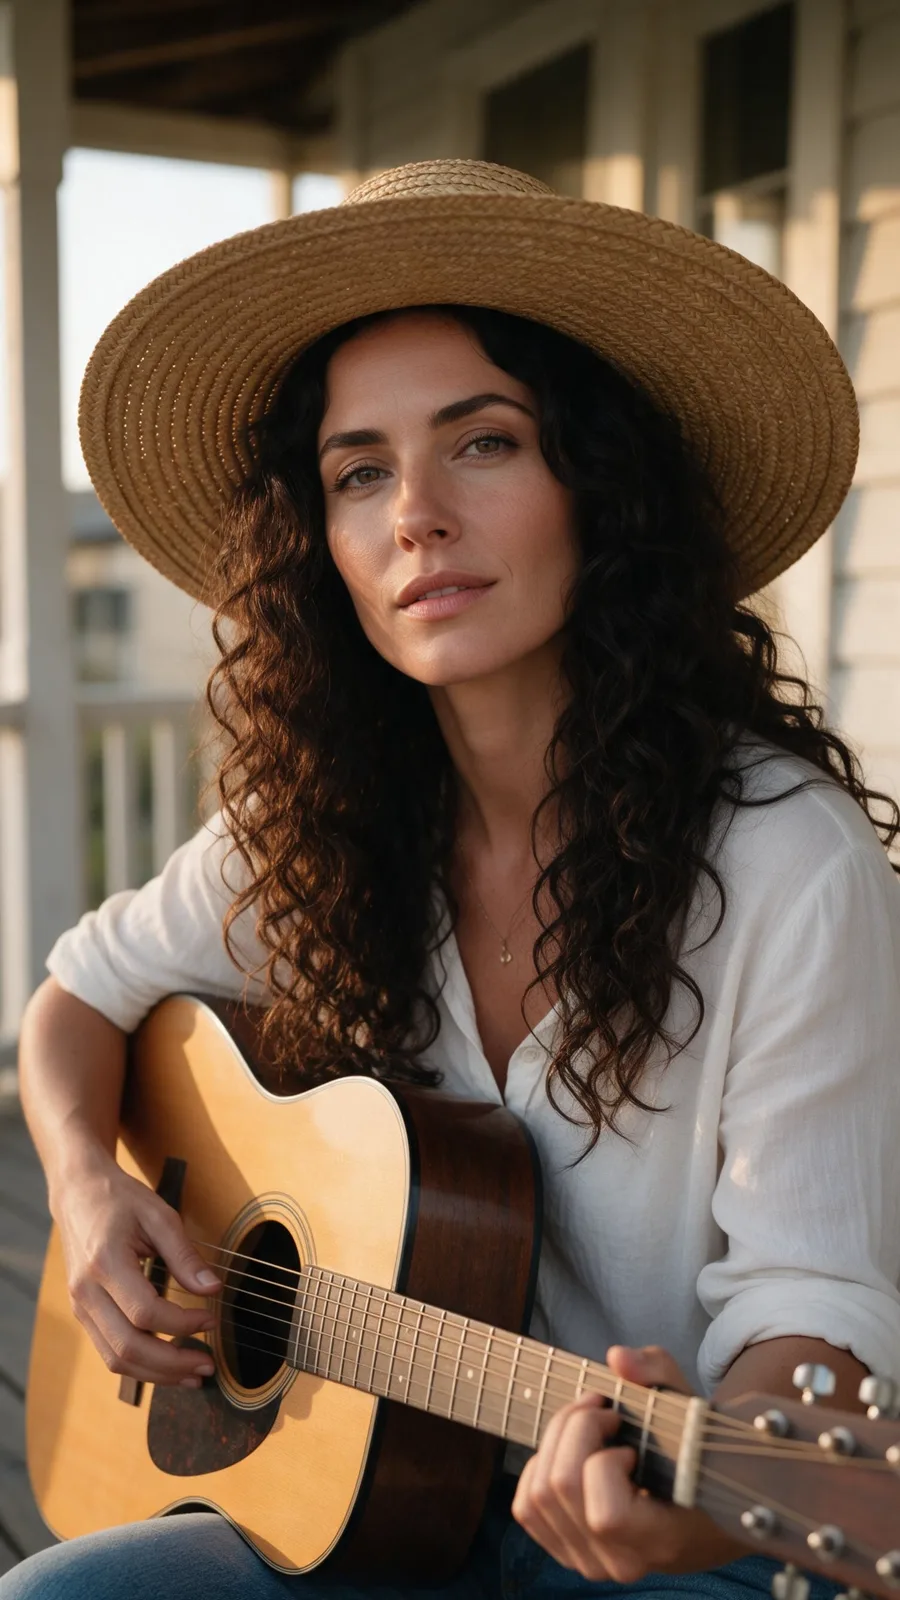
01OmniHuman 1.5 示例
一张肖像加一首原创歌曲,生成了 10 秒的表演:她在洒满阳光的门廊上边唱边摇摆,弹着吉他。想让你自己的照片唱歌,请看让照片唱歌。
OmniHuman 1.5 · 肖像+歌曲
她深情地歌唱,轻轻摇摆着弹奏吉他,表情自然,身体动作放松。
使用 OmniHuman 1.5 在 VlogMe Video Studio 中,由 Image Studio 生成的一张肖像和 Audio Studio 制作的原创歌曲生成。上方为该片段所用提示词的译文。
02直接使用此模型
通过 Google 或邮件链接登录后,VlogMe 会打开已选好 OmniHuman 1.5 的 Video Studio,并在生成前显示积分费用。
选择清晰肖像或受支持的数字人素材。
准备脚本或语音,并只使用已获授权的面孔和声音。
查看数字人流程及积分估算。
发布前检查口型、表情、声音和字幕。
相比更简单的数字人模型,费用更高、处理时间更长;时长由音频决定。
适合需要全身出镜的表演:带手势的主持人、歌手和乐手,以及远景或复杂构图中的角色。如果只是简单的口播,Hedra Avatar 费用更低。
可以。OmniHuman 1.5 直接在 VlogMe 的 Video Studio 中运行。通过本页表单打开时会预先选好该模型,确认设置后即可生成。
只要积分余额足以覆盖生成前显示的估算,任何账户都可以使用此模型。订阅为可选项,仅用于定期补充积分。
相比更简单的数字人模型,它费用更高、耗时更长,片段时长始终由您的音频决定。
以积分计费,价格取决于音轨时长。提交前会显示确切的积分价格,确认后才会开始生成。
可以。它能驱动全身表演:边说边做手势的主持人、歌手和乐手,以及更宽景别中的角色。如果只需要简单的口播头像,Hedra Avatar 更便宜也更快。
VlogMe 是独立产品。模型和提供商名称是其各自所有者的商标;可用性和功能可能会有变化。
最后审核