01Аудио на входе, видео на выходе
Начните с выпуска, который уже записан.
Выберите фрагмент на 15–90 секунд, экспортируйте его в MP3, WAV или M4A и добавьте фото ведущего. Видео повторяет длину и ритм фрагмента, а сама запись не переозвучивается.
Добавьте визуального ведущего к аудиовыпуску: портрет и фрагмент подкаста превращаются в готовый ролик.
 Загрузите фото ведущего
 Добавьте фрагмент подкаста
 Задайте кадр
 Запустите рендер
01Начало выпуска
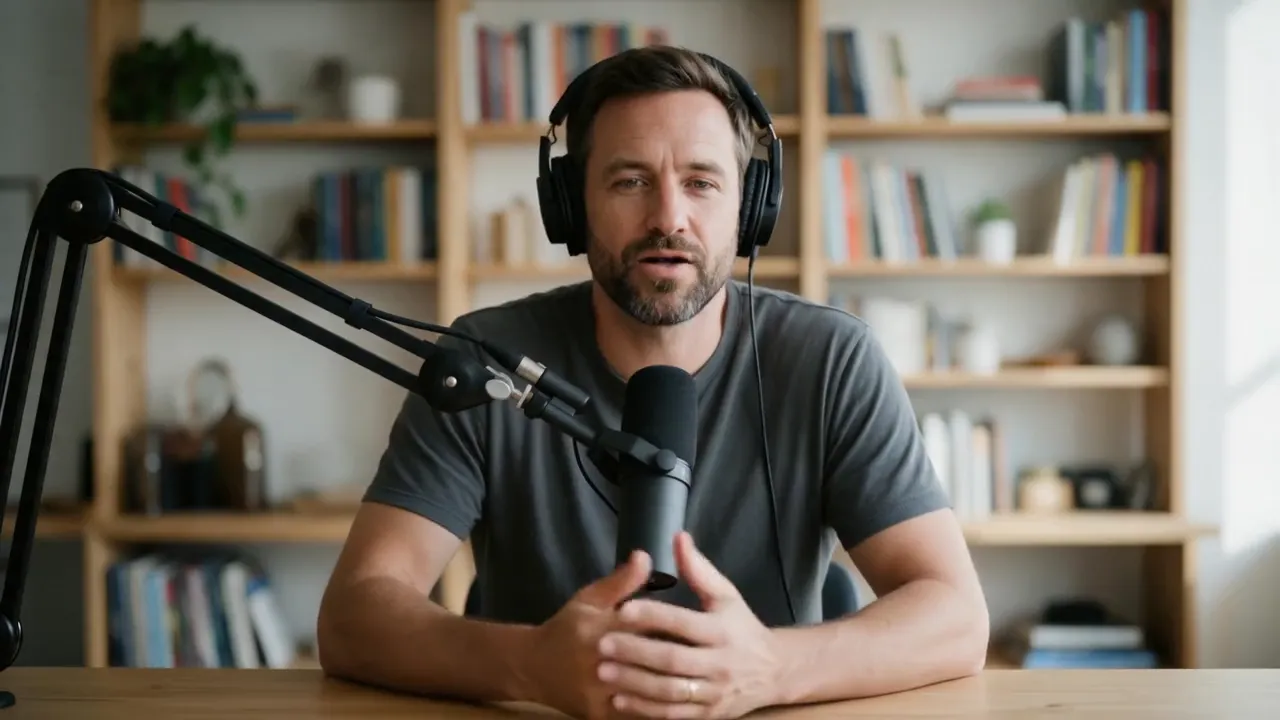
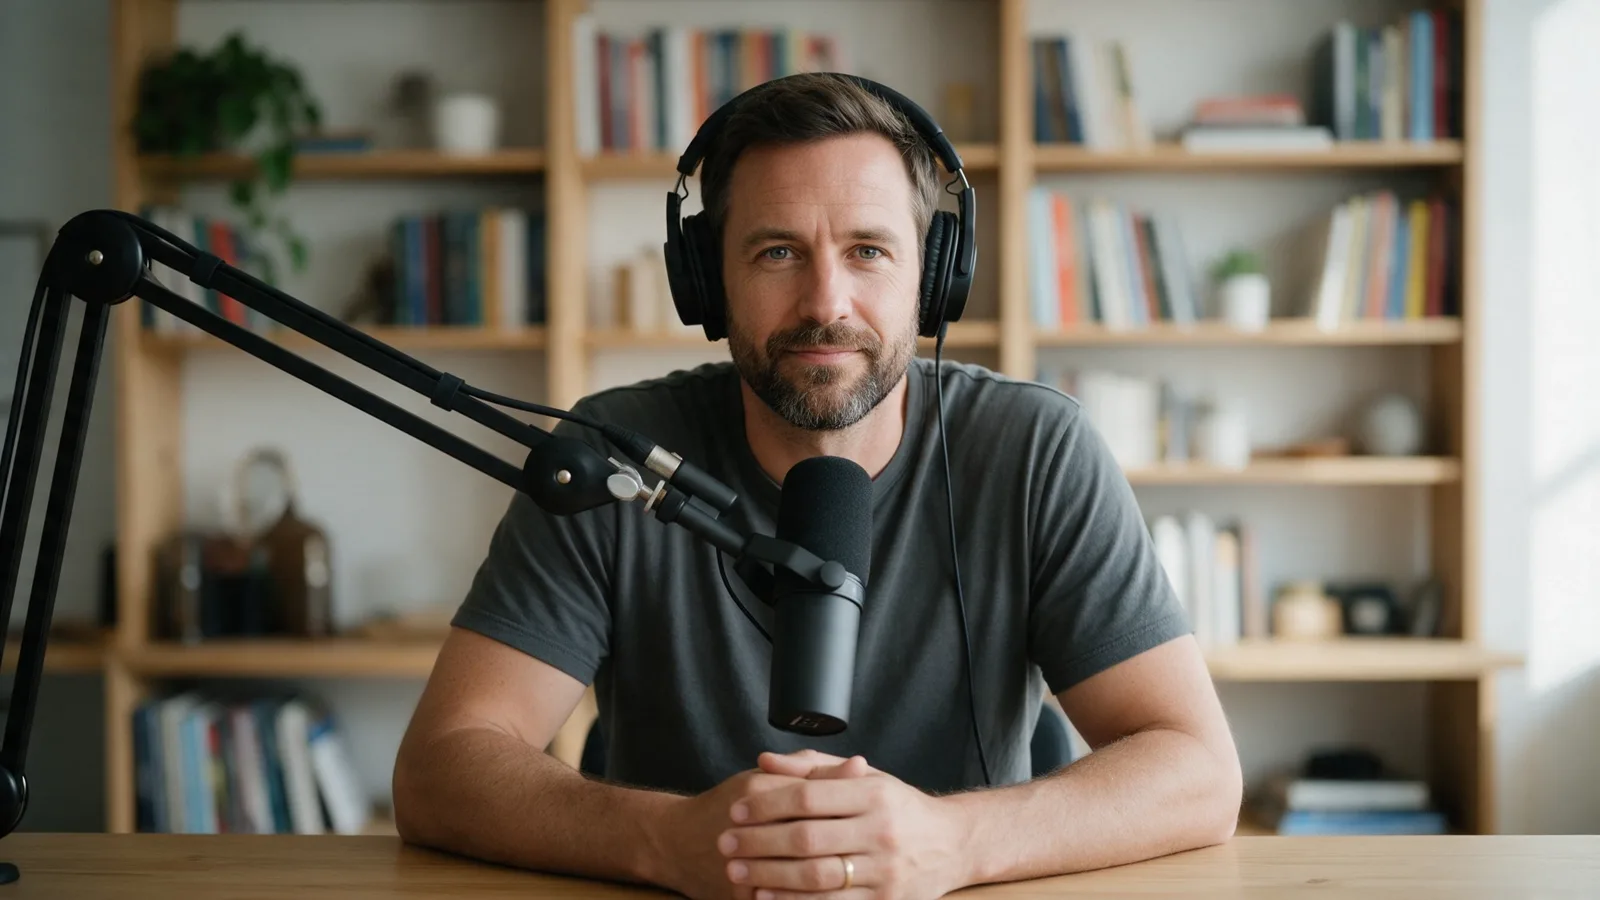
Бородатый ведущий у студийного микрофона — из одного сгенерированного портрета и вступления к выпуску, озвученного в ElevenLabs. Модель Hedra Avatar отрисовала его в 16:9 — в привычном формате подкаста на YouTube.
 Hedra Avatar · 16:916:9
02Показываем и объясняем
01Аудио на входе, видео на выходе
Выберите фрагмент на 15–90 секунд, экспортируйте его в MP3, WAV или M4A и добавьте фото ведущего. Видео повторяет длину и ритм фрагмента, а сама запись не переозвучивается.
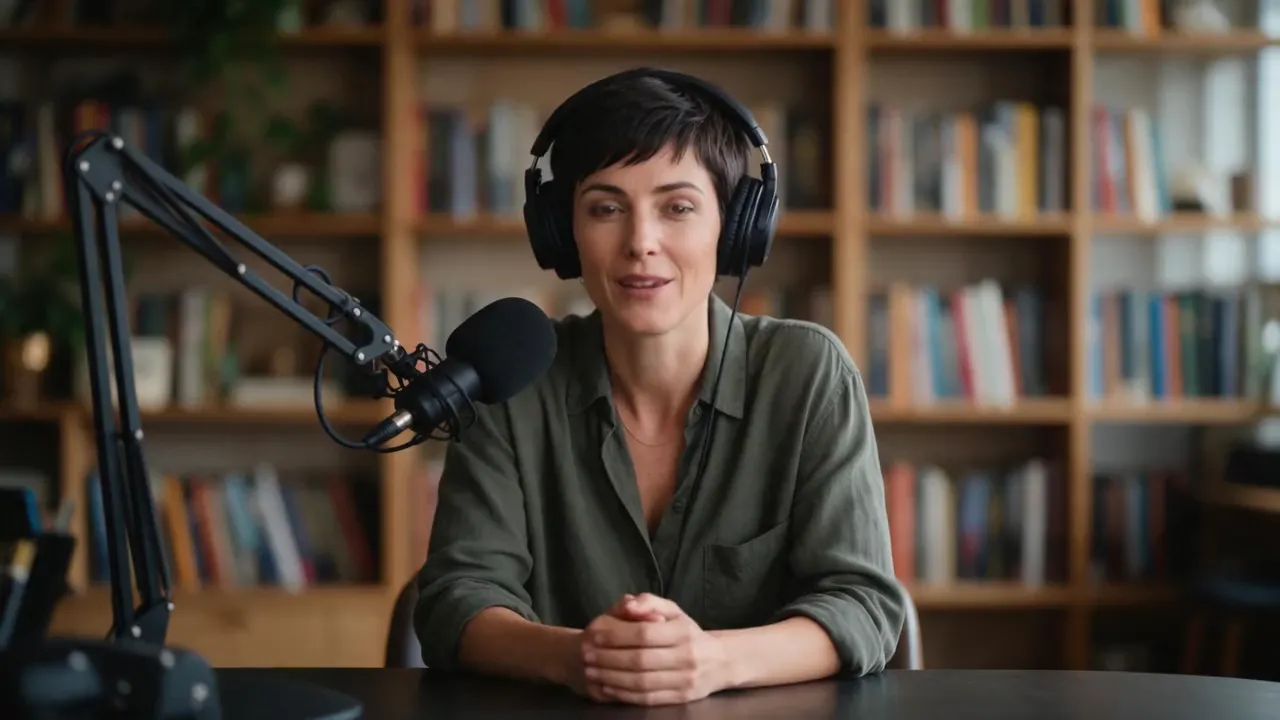 Соведущая · 16:916:9
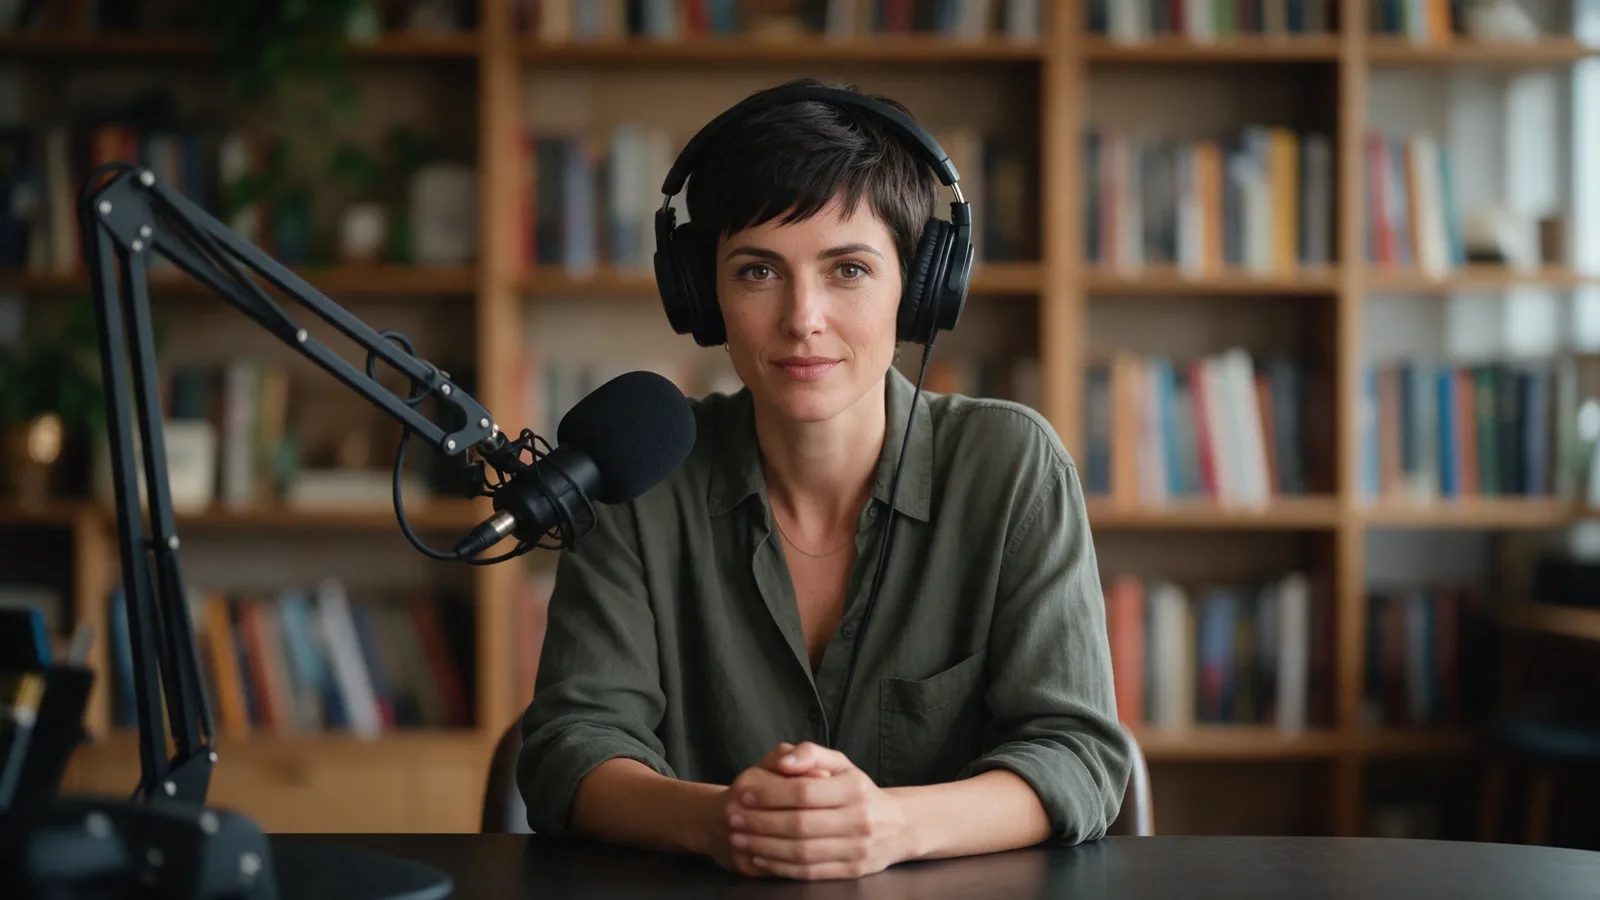
02Соведущая
Каждого участника рендерите из его фото и его аудио. Эта соведущая — отдельный портрет и отдельная реплика о вопросе, который пекарня каждое утро задавала клиентам. Она отрендерена в 16:9 за похожим столом, поэтому два ролика естественно чередуются.
03Клипы для Shorts
Отрендерите ведущего в 9:16 для Shorts, Reels и TikTok или обрежьте горизонтальный фрагмент до вертикали в Video Editor и добавьте заголовок перед публикацией.
Video StudioГенератор ИИ-аватаров
Все инструменты для говорящих аватаров03Как это работает
Загрузите чёткий портрет ведущего или персонажа.
Для соцсетей хорошо работает сфокусированный фрагмент на 15–90 секунд.
Аватар исполняет исходное аудио — остаётся добавить субтитры и экспортировать.
Готовые примеры
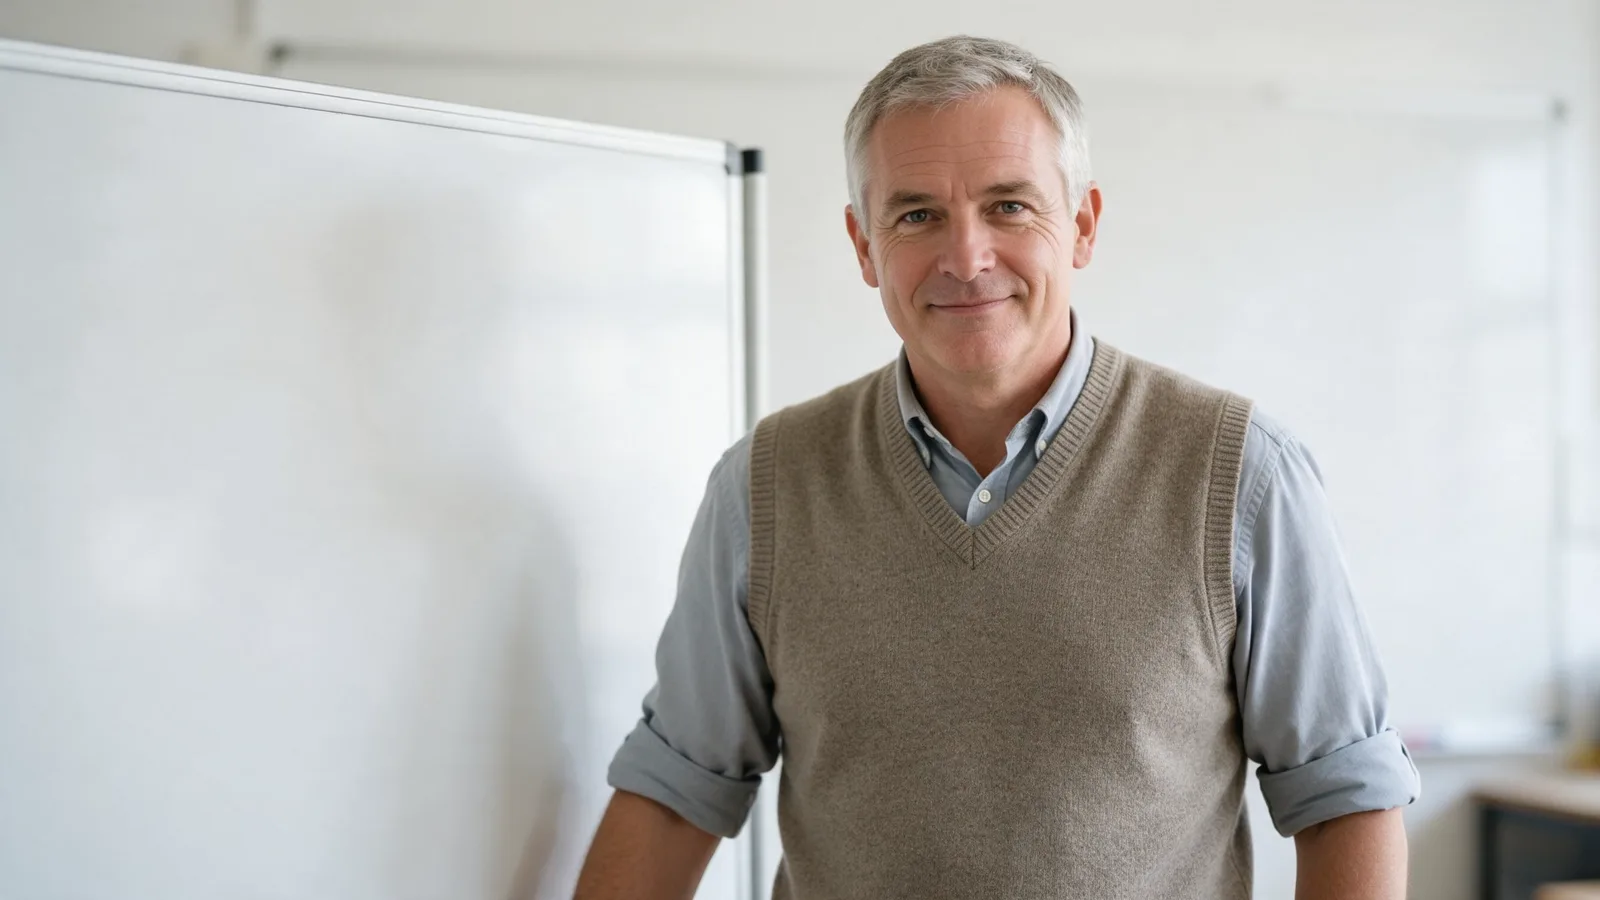
Утренняя сводка, тест камеры и урок о дробях
 Сводка · 16:916:9
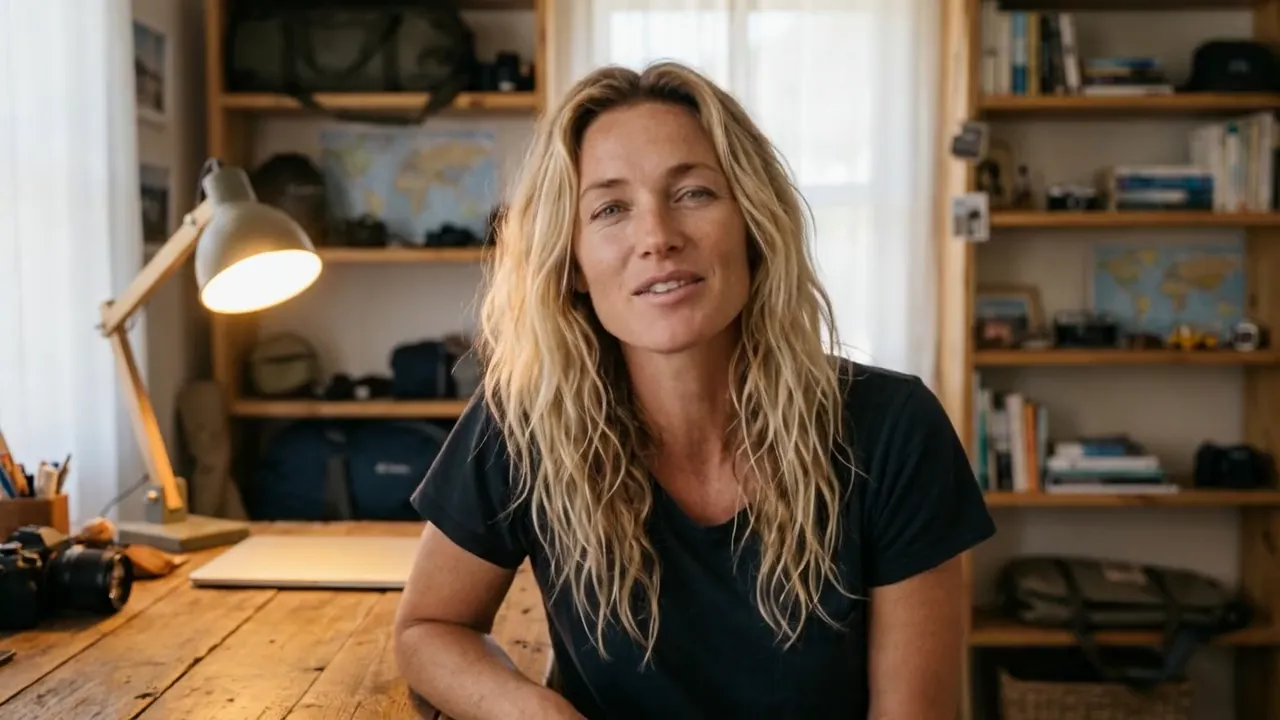 Тест камеры · 16:916:9
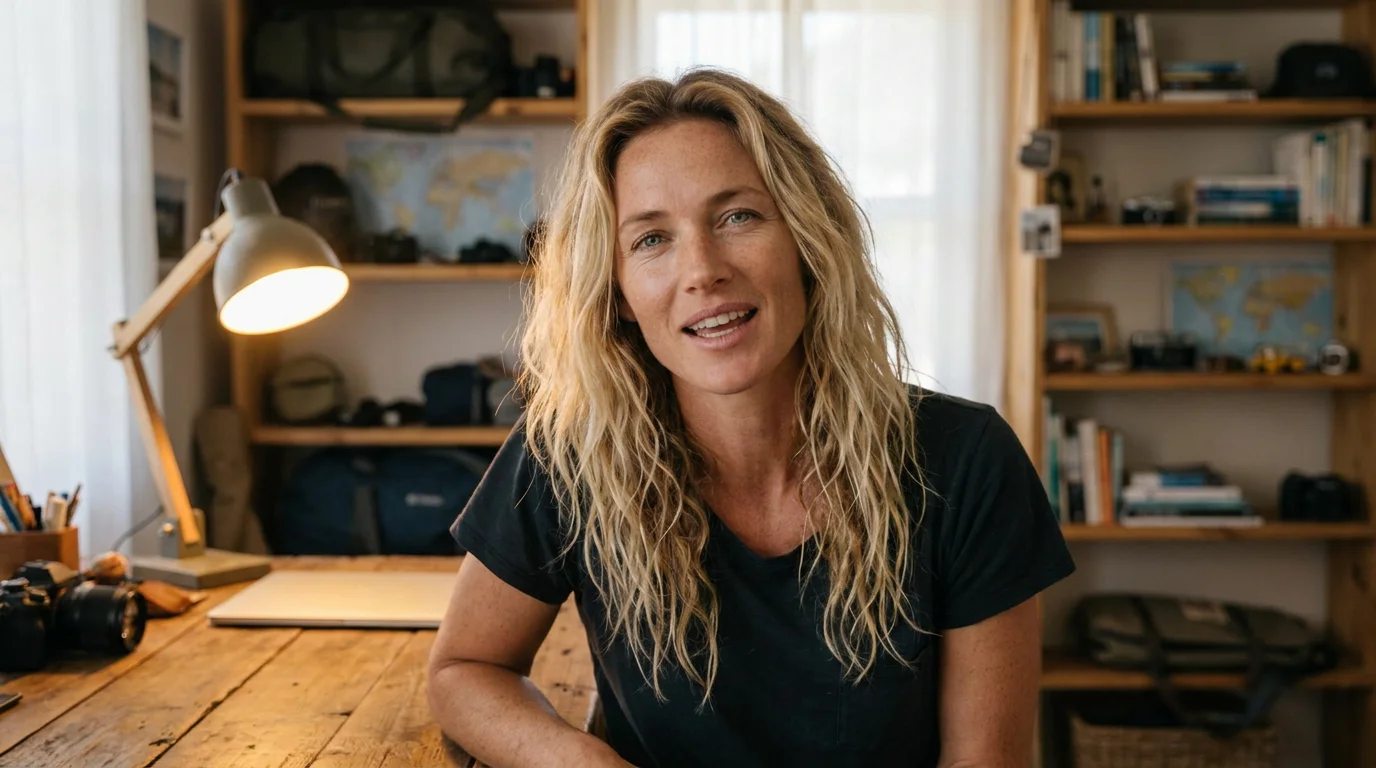
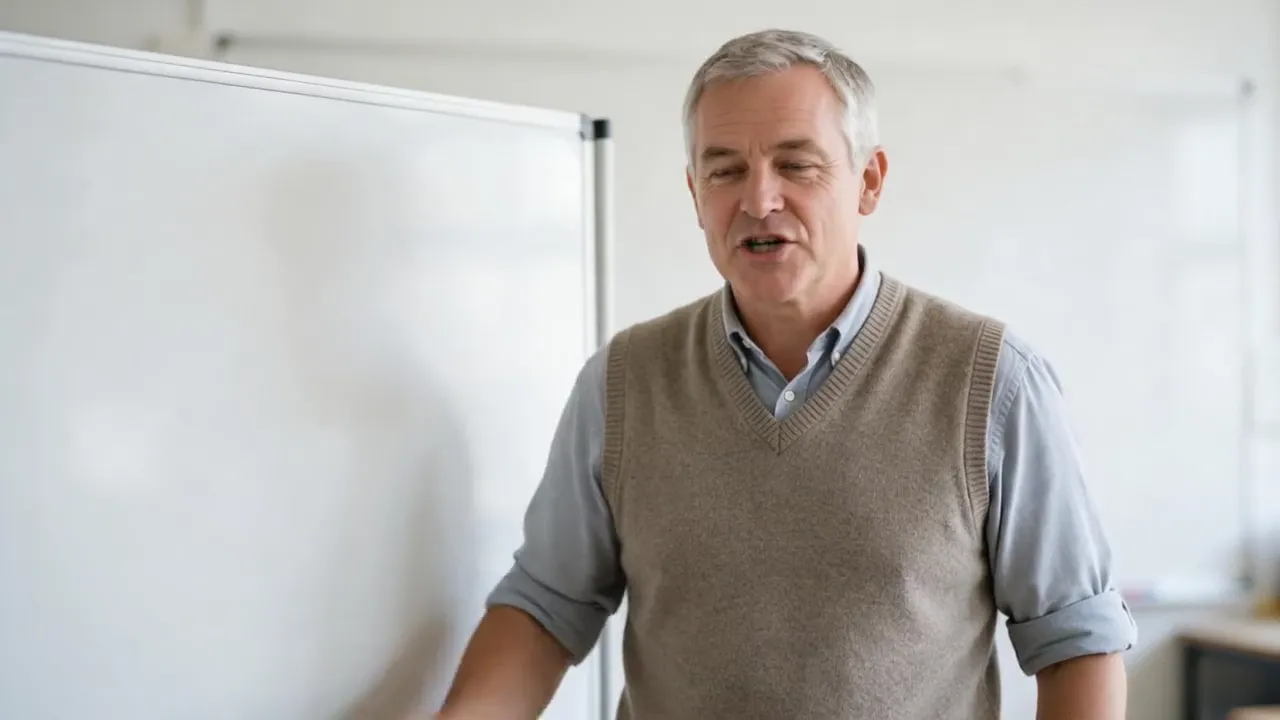 Урок · 16:916:9
Полный цикл ИИ-видео
Фото ведущих хранятся в Lab — рендерите каждый новый фрагмент, как только он готов. Очистите звук и сделайте субтитры SRT в Audio Studio, обрежьте ролик и добавьте заголовок в Video Editor, а для других рынков переведите его в DUB.
Вопросы перед созданием
Нет. Говорящий аватар следует загруженному аудиофайлу.
Короткие фрагменты для соцсетей проще смотреть, и они быстрее рендерятся. Длинное аудио можно разделить на несколько роликов.
Да. Сделайте субтитры SRT или VTT из того же аудио в Audio Studio или впишите короткий заголовок в ролик через Video Editor.
Да. Рендерите каждого участника из его фото и его фрагмента аудио — по одному ролику на участника или на реплику.
До десяти минут на видео в Hedra Avatar или до 60 секунд в OmniHuman 1.5. Если выпуск состоит из нескольких сцен, Director соберёт из них видео длиной до 3 минут.
Кредиты списываются за секунду аудио выпуска, поэтому длинный фрагмент стоит дороже: до рендера оставьте только ту часть, которую хотите опубликовать. Бесплатного тарифа нет: купите кредиты, когда будете готовы, — студия покажет оценку до рендера.
Выпуск готов?
Выберите фото ведущего и фрагмент здесь — аккаунт пока не нужен. Войдите, когда продолжите: оба файла загрузятся в Lab и откроются в Talking avatar, а расчёт кредитов вы увидите до рендера.
Оценка в кредитах до генерации · Кредиты — только когда они нужны