01带上声音
直接用已经定稿的那一条。
从 ElevenLabs 导出最终的 MP3、WAV 或 M4A,或在 VlogMe 的 Audio Studio 中生成声音。文件最大 50 MB;使用 Hedra Avatar 时,视频最长 10 分钟,时长始终与音频一致。
上传最终语音与肖像,VlogMe 会把真实的节奏、停顿与表达映射到数字人身上。
 导出语音
 添加肖像
 设定表演
 渲染视频
01放进语音,得到主持人
这位木匠说的是一段 9 秒、用 ElevenLabs v3 生成的音轨——和你从 ElevenLabs 导出的文件是同一种。Hedra Avatar 让肖像的口型与它同步:停顿、重音和换气都来自音频,声音本身不会被重新生成。
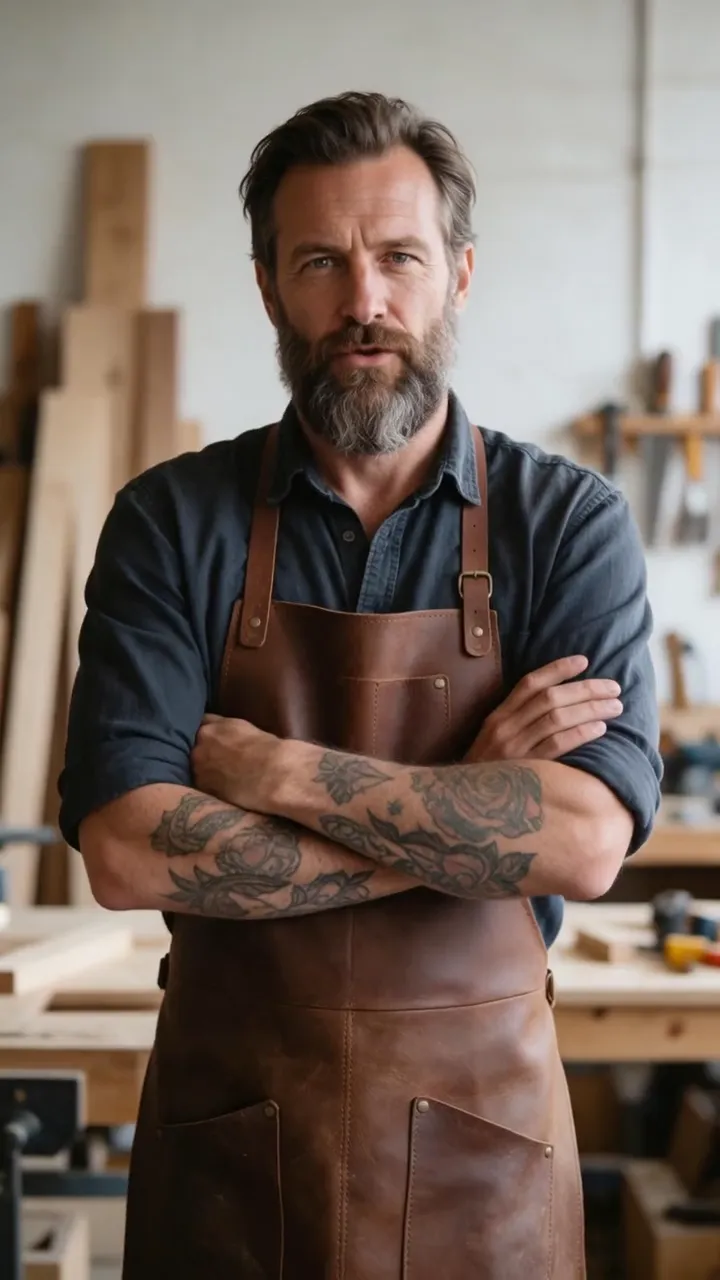 Hedra Avatar · 9:169:16
02先展示,再说明
01带上声音
从 ElevenLabs 导出最终的 MP3、WAV 或 M4A,或在 VlogMe 的 Audio Studio 中生成声音。文件最大 50 MB;使用 Hedra Avatar 时,视频最长 10 分钟,时长始终与音频一致。
 另一个声音 · 9:169:16
03使用方法
上传前,先在 ElevenLabs 中调好发音、停顿和重音。
使用你拥有或已获动画化授权的肖像。
VlogMe 把提供的音轨映射到数字人上,生成视频。
成片示例
新员工欢迎词、意大利语意面秘诀、工坊邀请
 入职9:16
 意大利语9:16
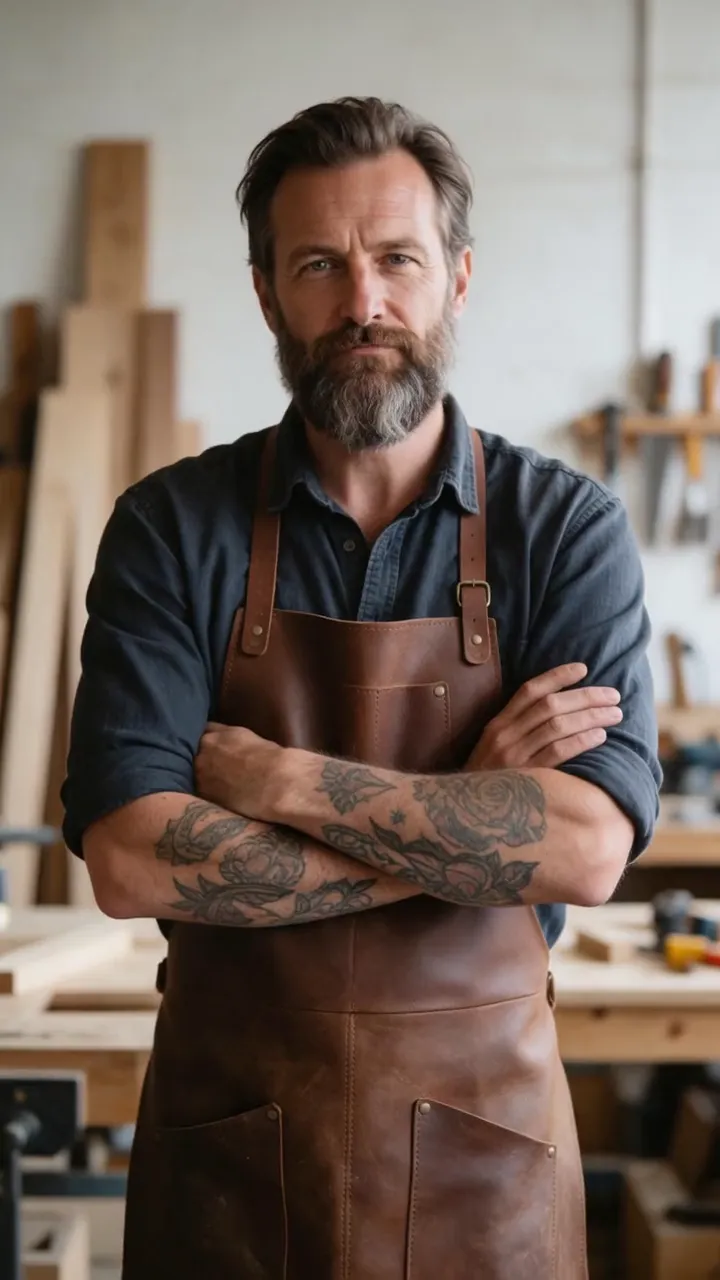 第三种声音9:16
完整 AI 视频创作
定稿的声音会原样保留。在 Video Studio 换一位主持人或画幅重新渲染,在 Audio Studio 用它生成 SRT 字幕,在 Video Editor 裁剪并加标题,成片还能交给 DUB 翻译。
创建前的问题
没有。ElevenLabs 是一家独立公司,也是其商标。VlogMe 的 Audio Studio 以 ElevenLabs 作为语音服务提供方,本流程也接受你从自己的 ElevenLabs 账号导出的音频。
不会。数字人口播流程会完全跟随你上传音频的节奏与音色。
只有在获得声音本人许可,并遵守语音服务条款和相关法律的情况下才可以。
最大 50 MB 的 MP3、WAV 或 M4A。Hedra Avatar 每条视频最多支持 10 分钟音频,OmniHuman 1.5 和 HeyGen Avatar V 最多 60 秒。
可以。任何干净的人声录音都行——其他文字转语音工具、播客麦克风或手机录音。
按您的 ElevenLabs 音轨秒数、以所选数字人模型的单价消耗积分;上传现成的声音不收费。生成需要付费,在 Director 中规划在使用额度内免费:准备好后再购买积分,渲染前工作室会显示预估。